Jev: model AI, który nie pisze tekstu, tylko podejmuje decyzje. Sprawdziłem go na polskich mailach
Jev to model językowy, który nie generuje tekstu. Zamiast odpowiedzi zwraca jedną z opcji, które sam mu wcześniej podasz, razem z prawdopodobieństwem, że to właściwy wybór. Powstał po to, żeby podejmować powtarzalne decyzje w oprogramowaniu: dokąd skierować zgłoszenie, którego modelu użyć, czy komentarz łamie zasady. Nie do rozmowy, nie do pisania, nie do kodowania.
Poniżej opisuję skąd się wziął, czym się różni od modeli, których używasz na co dzień, ile naprawdę kosztuje jedna decyzja według moich własnych pomiarów, i gdzie ma sens. Pokazuję też, gdzie się przewrócił na moim teście, bo to jest rzecz, której nie znalazłem w żadnym innym materiale.
Kto zrobił Jeva i kiedy
Za modelem stoi TypeSafe AI, firma trzech osób: Diogo Almeida jest prezesem, Erik Gafni dyrektorem technicznym, Sasha Sheng dyrektorką operacyjną. Almeida jest byłym badaczem OpenAI i pracował przy RLHF oraz ChatGPT. Prasa nazywa go współtwórcą ChatGPT, on sam pisze o tym ostrożniej: „w OpenAI pomagałem budować metody, które sprawiły, że modele językowe potrafią wykonywać polecenia i rozmawiać z ludźmi”.
Firma spędziła dwa lata w ukryciu i wyszła z niego 15 września 2026, ogłaszając jednocześnie rundę 40 milionów dolarów prowadzoną przez fundusz DCVC oraz premierę Jeva w trybie early access. Forbes podał wycenę 200 milionów dolarów, powołując się na osobę zbliżoną do transakcji, ale TypeSafe tego nie potwierdziło, więc traktuję tę liczbę jako niepewną.
Nazwa modelu pochodzi od Williama Stanleya Jevonsa i TypeSafe mówi to wprost: „Nazwaliśmy Jeva po Williamie Stanleyu Jevonsie. Spodziewamy się, że inteligencja maszynowa pójdzie ścieżką podobną do węgla, gdzie wzrost sprawności maszyny parowej doprowadził do wzrostu popytu”. Chodzi o paradoks, który Jevons opisał w XIX wieku: kiedy korzystanie z zasobu tanieje, jego całkowite zużycie rośnie, zamiast spadać.
Nazwa całej kategorii, „System One models”, pochodzi od Kahnemana i jego podziału na myślenie szybkie i wolne. To jest etykieta marketingowa TypeSafe na własną klasę produktu, nie termin z literatury naukowej.
Pogadajmy
Zrobić to razem?
Wdrażam takie rzeczy w firmach na co dzień. Umów 30 minut, pogadamy konkretnie o Twoim przypadku. Bez prezentacji sprzedażowej.
Umów bezpłatną rozmowę →
Łukasz ŚlusarskiTwórca important.is
Czym Jev różni się od Claude, GPT i Gemini
Modele, do których się przyzwyczailiśmy, są autoregresywne. Przewidują kolejny token, potem następny, i tak aż do końca odpowiedzi. Nawet jeśli poprosisz o jedno słowo, mechanizm pod spodem jest ten sam co przy pisaniu eseju.
Jev działa inaczej. Według TypeSafe używa nowej architektury i równoległego samplera, a metodę treningu nazywają Reinforcement Learning for Calibrated Decisions (RLCD). Model nie składa odpowiedzi kawałek po kawałku. Ocenia stan i zwraca gotową decyzję razem z rozkładem prawdopodobieństw.
Rozmiaru modelu, dokładnej architektury ani danych treningowych nie ujawniono. Nie ma publikacji naukowej. Wszystko powyżej to deklaracje producenta i tak je traktuj.
| Zwykły model (Claude, GPT, Gemini) | Jev | |
|---|---|---|
| Sposób działania | generuje token po tokenie | zwraca decyzję w jednym przebiegu |
| Wynik | tekst, który trzeba sparsować | typ danych z prawdopodobieństwem |
| Czy może wymyślić coś spoza listy | tak | nie, wybiera tylko z podanych opcji |
| Pewność odpowiedzi | trzeba wyprowadzać okrężnie | zwracana wprost jako liczba |
| Pisanie, kod, analiza | tak | nie |
Trzy typy pytań, które Jev przyjmuje
Do API wysyłasz dwie rzeczy: state, czyli materiał do oceny, oraz questions, czyli zestaw pytań. W jednym wywołaniu możesz zadać wiele pytań o ten sam materiał i to jest sedno oszczędności.
- choice wybiera jedną opcję z listy, maksymalnie 255 pozycji, i zwraca rozkład prawdopodobieństw dla wszystkich
- noul to pytanie tak/nie, zwracane jako liczba od 0 do 1
- score to ocena na skali opisanej słowami, od 2 do 10 poziomów
Endpoint to POST https://api.typesafe.ai/v1/systemone, model podajesz jako jev-latest. Limit kontekstu wynosi 64 tysiące tokenów na żądanie, w tym 32 tysiące na sam state. Limity przepustowości to 250 tysięcy tokenów na sekundę i 1200 żądań na minutę. Model obsługuje wyłącznie tekst.
Ile kosztuje jedna decyzja. Mój pomiar, nie cudzy
TypeSafe reklamuje Jeva hasłem o stukrotnej redukcji kosztów. To porównanie jest robione wobec modeli frontierowych rozwiązujących zadanie z pełnym rozumowaniem. Mnie interesowało co innego: jak Jev wypada wobec taniego modelu, którego naprawdę użyłbyś do klasyfikacji.
Metodologia. Ten sam polski mail, to samo zadanie: przypisz dział, oceń pilność, oceń poziom irytacji nadawcy. Pięć przebiegów na każdy model, z tej samej maszyny w Polsce, tego samego wieczoru. Podaję medianę, bo pojedynczy pomiar sieciowy nic nie znaczy. Liczby tokenów pochodzą z odpowiedzi API, ceny z oficjalnych cenników z 21 września 2026.
Jeśli interesuje Cię szerszy obraz tego, co ile kosztuje w świecie modeli, pisaliśmy osobno o tym, który model AI do czego wybrać i ile to naprawdę kosztuje.
| Model | Mediana czasu | Tokeny wej./wyj. | Koszt 1 decyzji | Koszt 1000 decyzji |
|---|---|---|---|---|
Jev (jev-latest) |
0,609 s | 496 / 80 | $0,0000208 | $0,021 |
| gpt-4.1-nano | 1,109 s | 215 / 31 | $0,0000339 | $0,034 |
| gemini-3.5-flash-lite | 0,734 s | 204 / 21 | $0,0001137 | $0,114 |
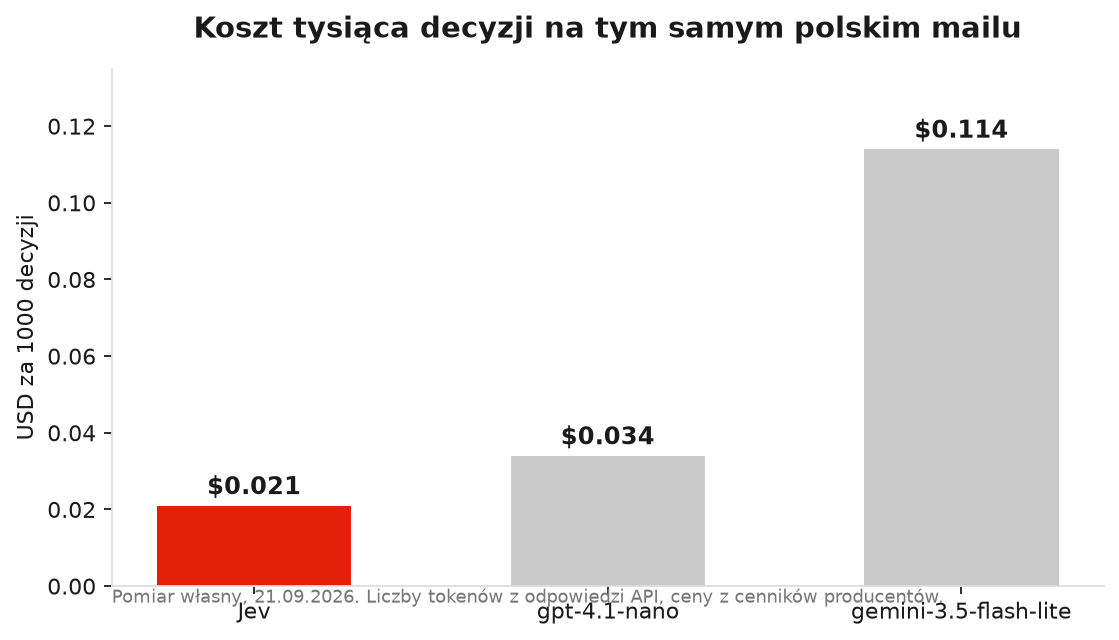
Z tej tabeli wychodzą trzy wnioski, z których dwa są niewygodne dla producenta.
Jev faktycznie jest najtańszy, ale nie stukrotnie. Wobec gpt-4.1-nano jest tańszy 1,6 raza, wobec gemini-3.5-flash-lite 5,5 raza. Stukrotna różnica pojawia się dopiero przy porównaniu z dużym modelem, którego i tak nikt rozsądny nie wstawiłby do sortowania maili.
Jev zużył prawie dwa i pół raza więcej tokenów wejściowych niż konkurenci, dokładnie 2,43 raza, i mimo to wyszedł taniej. Powód jest taki, że opisy opcji w criteria zajmują miejsce, ale stawka za token jest siedmiokrotnie niższa, a wyjście nie kosztuje nic.
Przewaga szybkości jest realna, ale skromna. 0,61 sekundy kontra 0,73 sekundy u Gemini to różnica 1,2 raza, nie czterdziestokrotna. Tu muszę być uczciwy: mój pomiar jest zdominowany przez drogę przez ocean, nie przez czas liczenia modelu. TypeSafe podaje 70 do 500 milisekund end-to-end i to jest zapewne prawda na ich zapleczu. Tyle że firmę działającą z Polski interesuje liczba, którą widzi u siebie, a ta wynosi około 0,6 sekundy.
Wolisz to zlecić?
30 minut, bez zobowiązań. Sprawdzimy czy to ma sens.
Zarezerwuj termin →
Gdzie Jev ma sens
Rozdzielanie poczty i zgłoszeń
Najbardziej oczywiste zastosowanie. Wiadomość przychodzi, model przypisuje dział, ocenia pilność i nastrój nadawcy w jednym wywołaniu. Przy tysiącu maili miesięcznie mówimy o dwóch groszach kosztu. Samo doprowadzenie takiej decyzji do skrzynki albo do zadania to już zwykła automatyzacja, a o tym, jak budować automatyzacje, które naprawdę działają, mamy osobny poradnik.
Filtr przed drogim modelem
Zamiast wysyłać każde zadanie do najmocniejszego modelu, najpierw pyta się Jeva, czy zadanie jest proste czy trudne. Proste leci do taniego modelu, trudne do drogiego. Krążą po sieci konkretne liczby o oszczędnościach rzędu siedemdziesięciu procent tokenów, ale szukałem ich pierwotnego źródła i go nie znalazłem, więc ich tu nie powtarzam. Sam mechanizm jest sensowny i łatwy do zmierzenia na własnym ruchu.
Sterowanie agentem w przeglądarce
Agent klikający po stronie spędza większość czasu na decyzjach typu „w co kliknąć” i „czy już przewinąć”. Każda taka decyzja podjęta przez duży model kosztuje i trwa. Powstał skill, który oddaje te ruchy Jevowi, a dużemu modelowi zostawia pisanie treści i sprawdzanie wyniku. Jego autorzy obiecują w opisie repozytorium „5 do 10 razy szybsze operacje w przeglądarce”. Zaznaczam, że to hasło z README, nie wynik badania, a identyczny opis wisi na czterech forkach tego projektu, więc cztery źródła są w rzeczywistości jednym.
Bramki bezpieczeństwa i moderacja
Czy komenda jest bezpieczna. Czy odpowiedź bota łamie zasady. Czy ten komentarz nadaje się do publikacji. Zamknięty zbiór odpowiedzi jest tu zaletą, bo model nie może wymyślić trzeciej drogi. Uwaga tylko, żeby nie pomylić tego z zabezpieczeniem: o tym, przed czym naprawdę trzeba chronić formularz na stronie, pisaliśmy osobno, i model decyzyjny tego nie zastąpi.
Ocena leadów
Gorący, ciepły, zimny, plus prawdopodobieństwo. Przy setkach zgłoszeń miesięcznie ręczne przekładanie z kupki na kupkę przestaje mieć sens.
Czego Jev nie zrobi. I gdzie przewrócił się na moim teście
Dokumentacja TypeSafe zawiera osobną stronę o słabościach modelu i jest w niej więcej uczciwości niż w materiałach prasowych. Najważniejsze ograniczenia:
- Czyta instrukcję dosłownie, nie domyśla się intencji stojącej za pytaniem
- Nie liczy. Błąd rośnie wraz z wielkością liczonego zbioru
- Daty czyta jak tekst, nie jak wielkości uporządkowane. Pytanie „czy termin minął” albo „ile dni zostało” jest poza jego zasięgiem
- Gubi się przy podwójnych przeczeniach i przy pytaniach wymagających kilku kroków rozumowania
- Trafność spada, gdy w materiale jest dużo treści niezwiązanej z pytaniem
- Jest podatny na prompt injection, czyli tekst, który sam argumentuje za swoją klasyfikacją
Do tej listy dokładam własne znalezisko, którego nie widziałem nigdzie indziej.
Pułapka jednoznacznego wyboru
Dałem Jevowi polską wiadomość, która celowo zawierała dwie sprawy naraz: zgłoszenie awarii formularza i pytanie o wycenę sklepu internetowego. Model odpowiedział:
wybór: support
pewność: 0.98
prawdopodobieństwa: support 0.99, sprzedaż 0.01
Pewność nie spadła ani o punkt. Model z pełnym przekonaniem wrzucił wiadomość do supportu i po cichu zgubił jedyny wątek w tym mailu, który był wart pieniądze.
To jest istotne, bo wzorzec zalecany i przez dokumentację, i przez poradniki integracyjne brzmi: bramkuj decyzje progiem pewności, a poniżej progu oddawaj sprawę człowiekowi. Tutaj taki próg by nie zadziałał. Ani 0,7, ani 0,9 nie zatrzymałoby tej wiadomości. Problemem nie była niepewność modelu, tylko to, że pytanie typu choice z definicji wymusza jedną odpowiedź.
Dla porządku: przy innym pytaniu w tym samym wywołaniu pewność spadła do 0,31, więc mechanizm działa. Po prostu nie zadziałał tam, gdzie był potrzebny.
Obejście, które sprawdziłem
Zamiast jednego pytania choice z wykluczającymi się opcjami, trzy niezależne pytania noul o tę samą wiadomość:
jest_awaria:     0.98
jest_sprzedaz:   0.96
jest_ksiegowosc: 0.14
Oba wątki złapane. Ten sam mail, ten sam koszt, inna konstrukcja pytania. Wniosek praktyczny jest prosty: choice stosuj tylko wtedy, gdy kategorie naprawdę się wykluczają. Wiadomość napisana przez człowieka rzadko się wyklucza.
Przy okazji potwierdziłem rzecz, o której dokumentacja nie mówi wprost: polski działa bez zarzutu, razem z ogonkami, mimo że nigdzie nie ma listy obsługiwanych języków.
Konkurenci, czyli co się wydarzyło w tydzień
Reakcja na premierę Jeva była gwałtowna. Serwis Latent.Space opublikował 19 września, cztery dni po premierze, zestawienie zatytułowane „Oto sześć klonów Jeva w dwa dni”.
| Projekt | Baza | Rozmiar | Licencja |
|---|---|---|---|
| Laya | ModernBERT-large | 421M | Apache 2.0 |
| Bespoke Nimble | Qwen3.5 LoRA | 9B | otwarta |
| SemIf (OpenJev) | Qwen3.5 | 4B i 35B | otwarta |
| DiffusionGemmaJev | model dyfuzyjny | brak danych | otwarta |
| Jevlike | same embeddingi | 40 KB | otwarta |
| Kev-0.5B | Qwen2.5 LoRA | 0,5B | otwarta |
Najdalej zaszła Laya od Convai Innovations. Chodzi lokalnie, na licencji Apache 2.0, i w materiałach producenta deklaruje 32,8 milisekundy na decyzję oraz trafność wyższą od Jeva.
To są jednak liczby producenta, mierzone na własnym poletku, bo Convai nie ma dostępu do API Jeva i jego wyniki przepisuje z cudzych publikacji. Znalazłem jeden niezależny pomiar, w którym ktoś uruchomił oba modele na tym samym materiale, czterdziestu zgłoszeniach supportowych, na MacBooku z M4 Max. Wyszło odwrotnie, niż sugeruje producent:
| Laya | Jev | |
|---|---|---|
| trafne decyzje | 23 z 40, czyli 57% | 31 z 40, czyli 78% |
| czas decyzji | 7,6 ms lokalnie | 588 ms przez API |
Czyli Jev był wyraźnie trafniejszy, a Laya nieporównanie szybsza, bo nie wychodzi poza maszynę. Autor tego pomiaru zbudował z tego kaskadę: Laya obsługuje sama 45 procent ruchu, resztę oddaje Jevowi, i całość dorównuje trafnością samemu Jevowi przy średnio 327 milisekundach.
Na marginesie, ich 588 milisekund dla Jeva jest bardzo blisko mojej mediany 609 milisekund, mierzonej zupełnie niezależnie i z innego kraju. To dobry znak dla obu pomiarów.
Laya na polskiej poczcie. Drugi pomiar własny
Wszystkie dostępne porównania obu modeli są na angielskim albo chińskim. Polskiego nie sprawdził nikt, więc zrobiłem to sam.
Metodologia. Laya 0.3.5 zainstalowana z PyPI, uruchomiona lokalnie na MacBooku z układem Apple, oba publiczne checkpointy: angielski i wielojęzyczny. Trzy polskie maile, te same pytania co u Jeva, pięć przebiegów na każdy przypadek, bez dotrenowania modelu.
Trzeci mail ułożyłem tak, żeby był naprawdę trudny. Partner przysyła fakturę, pisze że sklep od trzech tygodni nie przyjmuje płatności, że dwa jego maile zostały bez odpowiedzi, i pyta, jak widzimy dalszą współpracę. Nikt nie podnosi głosu, a grunt się pali.
| Jev | Laya wielojęzyczna | Laya angielska | |
|---|---|---|---|
| Jasne zapytanie o wycenę, dział | sprzedaż 0,99 | support 0,67 | sprzedaż przy pewności 0,02 |
| Ten sam mail, poziom irytacji (0 do 2) | 0,03 | 1,39 | 0,83 |
| Trudny mail, dział | księgowość 0,98 | księgowość 1,00 | support przy pewności 0,01 |
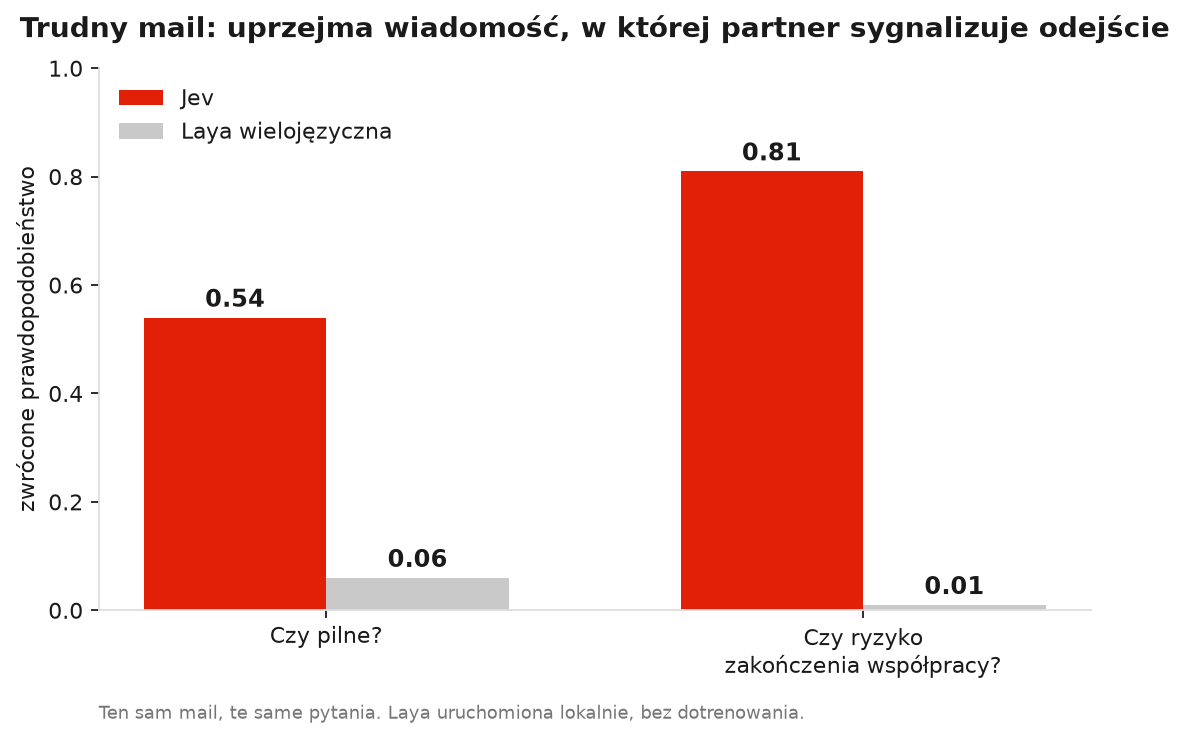
| Trudny mail, pilność | 0,54 | 0,06 | 0,86 |
| Trudny mail, ryzyko odejścia | 0,81 | 0,01 | nie badane |
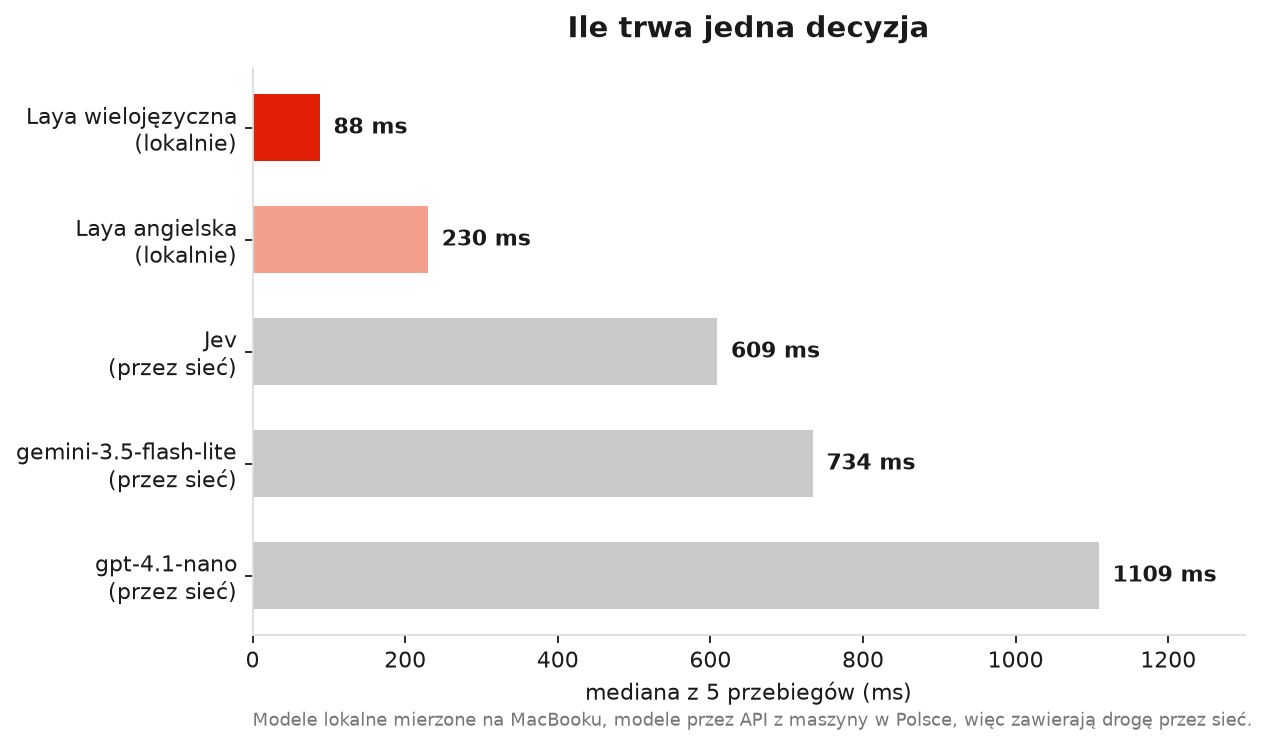
| Czas decyzji, mediana | 609 ms przez sieć | 88 ms lokalnie | 230 ms lokalnie |
Najważniejsza jest ostatnia para liczb. Pytanie brzmiało, czy nadawca sygnalizuje możliwość zakończenia współpracy. Jev odpowiedział 0,81, Laya 0,01. Zdanie o dalszej współpracy postawione po wyliczeniu zaniedbań jest w polskiej korespondencji zapowiedzią rozstania, a model uznał to za praktycznie wykluczone. Przy okazji ocenił sprawę jako niepilną. Kolejka oparta na tych odpowiedziach wrzuciłaby ten mail do księgowości jako spokojną rutynę.
Laya pomyliła się też na najłatwiejszym przykładzie, kierując wiadomość zaczynającą się od słów „piszę w sprawie wyceny nowej strony” do supportu. Spokojny mail oceniła na 1,39 w skali irytacji.
Checkpoint angielski na polskim po prostu zgaduje. Rozkład 0,42 do 0,30 do 0,28 przy pewności 0,02 to rzut monetą. Sama biblioteka wyrzuciła przy jego ładowaniu ostrzeżenie, że ten checkpoint ma temperatury poza dopuszczalnym zakresem, więc jego pewności są nieskalibrowane. To niezręczne, bo kalibracja jest głównym hasłem tego projektu.
Jedno Laya wygrywa bezdyskusyjnie: jest około siedem razy szybsza i nic nie opuszcza Twojej maszyny. 88 milisekund kontra 609.
I zastrzeżenie, bez którego ten test byłby nieuczciwy: Laya jest pomyślana do dotrenowania na własnych danych, a ja uruchomiłem ją bez tego. To jej najgorszy możliwy scenariusz.
Trzeba jednak dodać, że producent mówi to samo, i to bez owijania. Na karcie modelu wielojęzycznego stoi wprost: „Blisko poziomu przypadku na typed-decisions bez dotrenowania, 0,342 przy losowej podstawie 0,318. Dotrenuj pod konkretny przepływ pracy, stamtąd bierze się zdolność.” Convai nie udaje, że da się tego użyć prosto z pudełka.
Wniosek brzmi więc „surowa Laya nie nadaje się do polskiej poczty, i jej twórcy też tak uważają”, a nie „Laya jest słabym modelem”. Pokrywa się to z chińskim pomiarem wyżej, gdzie również przegrała trafnością.
Skala poprawy po dotrenowaniu bywa zresztą duża. Opublikowane przez Convai wyniki per język pokazują skoki z 0,110 do 0,400 dla arabskiego, z 0,100 do 0,387 dla hindi i z 0,110 do 0,490 dla koreańskiego. Dla polskiego ani żadnego innego języka słowiańskiego nikt takiego modelu jeszcze nie opublikował.
Jedna rzecz łączy te projekty i mówi sporo o tym, jak powstały: wszystkie trenowano na danych w stu procentach syntetycznych. Nikt nie zbierał prawdziwych decyzji, tylko kazano modelowi generować przykłady.
Ta fala wygląda też od środka gorzej, niż z nagłówka. Pod nazwą OpenJev funkcjonuje co najmniej pięć niezależnych repozytoriów, a część z nich to forki z przepisanym README, podawane jako osobna praca. Katalogi „awesome-jev” są zduplikowane na czterech kontach. Licząc uczciwie, osobnych podejść jest mniej, niż się wydaje.
Na 21 września 2026 nie znalazłem własnego modelu decyzyjnego od OpenAI, Anthropic, Google, Cohere ani Mistrala. Formułuję to ostrożnie, bo brak znaleziska to nie to samo co brak produktu.
Została jeszcze droga klasyczna, czyli dotrenowanie własnego BERTa. Dotrenowanie ModernBERT-base na piętnastu tysiącach przykładów przez pięć epok zajmuje 321 sekund na GPU, czyli grosze. Barierą nigdy nie był sprzęt. Barierą są oznaczone dane.
Krytyka, której nie ma w komunikatach prasowych
Wątek o Jevie na Hacker News zebrał 1942 punkty i 510 komentarzy, licząc na 21 września 2026, i sporo w nim chłodnej wody.
Najczęstszy zarzut brzmi: to jest zwykły klasyfikator zero-shot w dobrym opakowaniu. Komentujący wskazują, że dotrenowany BERT robił to samo lata temu, a nowością jest głównie słownictwo.
Drugi zarzut dotyczy hasła „nie halucynuje”. Ograniczenie wyjścia do listy nie usuwa błędów, tylko zmienia ich postać. Model nadal może wybrać złą opcję, po prostu robi to w poprawnym typie danych. Jeden z komentujących porównał to do sprzedawania łodzi z argumentem, że nie trzeba w niej wymieniać opon. Mój test z dwuznacznym mailem jest dokładnie tym przypadkiem: zero halucynacji, pełna pewność, zgubiona sprawa.
Trzeci zarzut dotyczy benchmarków. Porównywanie 70 milisekund z kilkoma minutami nie jest uczciwe, jeśli model odniesienia wykonuje przy tym pełne rozumowanie.
W obronie modelu pada argument, że nowość leży w metodzie treningu i w tym, że Jev generalizuje między dziedzinami bez danych treningowych pod konkretny przypadek, czego dotrenowany BERT wymaga. I to jest, moim zdaniem, właściwa oś sporu. Nie „czy to jest przełom”, tylko „czy oszczędzasz sobie zbierania oznaczonych danych”.
Komu to się opłaca
Jev nie jest kolejnym modelem do rozmowy i nie ma być. Jest tanim, szybkim klockiem do jednej rzeczy: podejmowania decyzji w zamkniętym zbiorze odpowiedzi.
Po własnych pomiarach widzę to tak.
Sięgnij po Jeva, jeśli masz powtarzalne decyzje na tekście, nie masz oznaczonych danych historycznych i chcesz, żeby zadziałało dziś. Opisujesz opcje słowami i gotowe. Przy skali typowej dla małej albo średniej firmy koszt jest zaniedbywalny w każdym z porównywanych wariantów, więc prawdziwą przewagą nie jest cena, tylko to, że model nie może wyjść poza listę i że zwraca pewność jako liczbę.
Rozważ Layę albo dotrenowanego BERTa, ale tylko jeśli masz archiwum poprawnych decyzji i zamierzasz je wykorzystać do treningu. Mój test pokazał, że surowa Laya na polskiej poczcie się nie broni. Po dotrenowaniu dostajesz jednak coś darmowego, siedem razy szybszego i działającego lokalnie, czyli bez wysyłania treści na zewnątrz. Przy danych osobowych to bywa argument ważniejszy niż wszystkie powyższe liczby.
Zostań przy zwykłym tanim modelu, jeśli Twoje decyzje wymagają choćby odrobiny rozumowania, dotyczą dat albo liczb, albo jeśli i tak musisz zaraz potem coś napisać. Wtedy drugi model w łańcuchu jest kosztem, nie oszczędnością.
I niezależnie od wyboru: projektuj pytania tak, żeby wielowątkowa wiadomość nie musiała się zmieścić w jednej szufladzie. To był najdroższy wniosek z moich testów i jedyny, który znalazłem sam.
W important.is podchodzimy do takich narzędzi tak samo jak do każdej innej technologii. Najpierw sprawdzamy na prawdziwych danych, czy decyzja w ogóle daje się zautomatyzować, a dopiero potem budujemy wokół tego proces. Model, który myli się szybko i tanio, nadal się myli.
Jak zacząć, krok po kroku
Jeśli chcesz sprawdzić Jeva na własnym materiale, potrzebujesz konta w konsoli TypeSafe i klucza API. Poniżej dokładnie to wywołanie, którego użyłem w testach opisanych wyżej.
curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer TWOJ_KLUCZ" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": "Dzień dobry, od wczoraj formularz na stronie nie wysyła wiadomości. Przy okazji chcieliśmy dopytać o wycenę sklepu.",
    "questions": {
      "jest_awaria": {
        "type": "noul",
        "instructions": "Czy wiadomość zgłasza problem techniczny na istniejącej stronie?"
      },
      "jest_sprzedaz": {
        "type": "noul",
        "instructions": "Czy wiadomość zawiera zapytanie o wycenę nowej pracy?"
      }
    }
  }'
W odpowiedzi dostaniesz liczby od 0 do 1 dla każdego pytania oraz zużycie tokenów. Trzy rzeczy, które oszczędzą Ci pierwszej rundy błędów.
Opisuj opcje pełnymi zdaniami. Pole criteria to nie są etykiety, tylko wyjaśnienia dla modelu. Różnica między „faktury” a „faktury, płatności, przypomnienia o zaległościach” przekłada się wprost na trafność.
Zadawaj wiele pytań w jednym wywołaniu. Płacisz głównie za materiał w state, a nie za liczbę pytań. W moich testach dołożenie trzeciego pytania praktycznie nie zmieniło czasu odpowiedzi.
Zapisuj prawdopodobieństwa, nie tylko sam wybór. Bez nich nie zbudujesz progu, poniżej którego sprawa idzie do człowieka. A jak pokazałem wyżej, nawet z nimi trzeba pilnować konstrukcji pytania.
Najczęstsze pytania
Czym różni się Jev od ChatGPT? ChatGPT generuje tekst token po tokenie i może napisać dowolną odpowiedź. Jev nie generuje niczego. Wybiera jedną z opcji, które sam mu podałeś, i podaje prawdopodobieństwo tego wyboru. Nie da się z nim rozmawiać ani poprosić go o napisanie maila.
Ile kosztuje Jev? 0,042 dolara za milion tokenów wejściowych, wyjście bez opłat. W moim pomiarze jedna decyzja na podstawie krótkiego maila kosztowała około 0,0000208 dolara, czyli tysiąc decyzji wyszło na dwa centy.
Czy Jev obsługuje język polski? Tak. Sprawdziłem na polskich wiadomościach z polskimi znakami i model poprawnie przypisywał dział oraz oceniał nastrój nadawcy. Oficjalna dokumentacja nie podaje listy obsługiwanych języków.
Czy Jev może halucynować? Nie może zwrócić odpowiedzi spoza listy, którą mu podasz. Może natomiast wybrać złą opcję i zrobić to z wysoką pewnością, co sprawdziłem na dwuznacznej wiadomości. Gwarancja dotyczy formy odpowiedzi, nie jej trafności.
Gdzie zdobyć klucz API do Jeva? Przez konsolę TypeSafe pod adresem console.typesafe.ai. Model jest też dostępny przez Vercel AI Gateway jako typesafe-ai/jev. Uważaj na serwisy oferujące „klucz bez kolejki” i sprzedające pakiety kartą, bo to nie są kanały producenta.
Czy istnieje darmowa alternatywa dla Jeva? Tak, Laya na licencji Apache 2.0, którą uruchomisz na własnym serwerze. W moim teście na polskich mailach, bez dotrenowania, myliła się na tyle często, że nie nadawała się do rozdzielania poczty. Jest za to około siedem razy szybsza od Jeva i nic nie wysyła na zewnątrz. Sensu nabiera dopiero wtedy, gdy masz własne oznaczone dane i ją na nich dotrenujesz.
Źródła
- TypeSafe AI i wpis „Introducing System One models and Jev”, czyli materiał producenta
- Dokumentacja Jeva, w tym pełne API, limity modelu i strona o słabościach
- Wątek o Jevie na Hacker News, 1942 punkty, odczyt 21.09.2026
- Laya na Hugging Face oraz karta wersji typed-decisions
- laya-jev-lab, niezależny pomiar obu modeli i kaskada
- Latent.Space o sześciu klonach Jeva z 19.09.2026
- Philipp Schmid o dotrenowaniu ModernBERT, źródło liczby 321 sekund
Pomiary w tym artykule wykonałem 21 września 2026, po pięć przebiegów na każdy przypadek. Jeva, gpt-4.1-nano i gemini-3.5-flash-lite odpytywałem przez API z maszyny w Polsce, więc podane czasy zawierają drogę przez sieć. Layę 0.3.5 uruchamiałem lokalnie na MacBooku z układem Apple, w obu publicznych checkpointach, bez dotrenowania. Ceny pochodzą z oficjalnych cenników TypeSafe, OpenAI i Google z tego samego dnia. Wyniki cudze, tam gdzie je przytaczam, są oznaczone jako cudze.
raz na jakiś czas
Zostań w pętli
Nowe artykuły, narzędzia i case study prosto na maila. Bez spamu, bez sprzedaży.