AI i Automatyzacje
AGENTS.md to zwykły plik Markdown w repozytorium, w którym zapisujesz agentowi AI to, czego nie wyczyta z samego kodu: komendy budowania i testów, niestandardowe zasady, granice. Claude Code czyta też CLAUDE.md, Codex AGENTS.md, Cursor oba. Pisz go krótko, ręcznie i trzymaj w gitcie.
Łukasz Ślusarski, important.is. Stan na 11 listopada 2026. Opracowane na podstawie dokumentacji Claude Code, Codex i Cursor, strony standardu agents.md oraz badania Gloaguen i in. (arXiv 2602.11988).
Jeśli budujesz aplikację z agentem, po kilku sesjach zauważysz ten sam wzorzec: agent odpala złą komendę testów, wstawia bibliotekę, której nie używasz, albo pisze w stylu, którego nie chcesz. Poprawiasz to w czacie, a w następnej sesji wszystko wraca, bo agent nie pamięta poprzedniej rozmowy. Plik instrukcji w repozytorium jest od tego, żeby poprawka została.
Ten tekst jest dla osób i firm, które trzymają kod na GitHubie i chcą go potem utrzymywać. Pokazuję, który plik wybrać, ile ma mieć linii, co do niego wpisać i czego nie wpisywać. Opieram się na dokumentacji narzędzi i na jednym badaniu, które trochę psuje popularne przekonania o takich plikach. Wyboru samych narzędzi i modeli tu nie porównuję, o tym pisaliśmy osobno. Piszę to także z własnej praktyki: plik instrukcji w naszym couchterm ma około 6 KB i każe między innymi dopisywać test do zmiany w tym samym commicie (opis na końcu).
| Pytanie | Odpowiedź | Źródło |
|---|---|---|
| Jaki plik, gdy używasz kilku agentów? | AGENTS.md jako jedyne źródło prawdy, a w CLAUDE.md jedna linia @AGENTS.md | dokumentacja Claude Code |
| Jak długi? | Claude Code: poniżej 200 linii na plik. Cursor: reguły poniżej 500 linii. Codex: limit ładowania 32 KiB łącznie | dokumentacje narzędzi |
| Czy ma pomagać agentowi? | Pliki pisane przez LLM nie poprawiły wyników, pisane przez ludzi tylko nieznacznie, a koszt rósł w obu przypadkach | arXiv 2602.11988 |
| Co wpisać? | Komendy, niestandardowe zasady, granice. Przeglądu repozytorium nie | agents.md, arXiv 2602.11988 |
| Czy to wektor ataku? | Tak, plik jest zaufanym wejściem agenta. Przeglądaj jego zmiany jak konfigurację CI | NVIDIA AI Red Team |
Zrobić to razem?
Wdrażam takie rzeczy w firmach na co dzień. Umów 30 minut, pogadamy konkretnie o Twoim przypadku. Bez prezentacji sprzedażowej.
Umów bezpłatną rozmowę →
AGENTS.md to otwarty format pliku Markdown z instrukcjami dla agentów kodujących, opisany na stronie agents.md jako „README dla agentów”. Zapisujesz w nim to, co zaśmiecałoby README dla ludzi: kroki budowania, testy, konwencje. Standardem opiekuje się Agentic AI Foundation działająca w ramach Linux Foundation. Strona podaje, że używa go „ponad 60 tysięcy” projektów open source, bez daty tego pomiaru. Lista zgodnych narzędzi ma ponad 20 pozycji, między innymi Codex, Cursor, Gemini CLI, GitHub Copilot, Windsurf i Zed. CLAUDE.md to plik tego samego rodzaju, ale z ekosystemu Claude Code. Format Markdown jest zwykły, bez wymaganych nagłówków. Różnica jest w tym, kto go czyta i jakie ma dodatki. CLAUDE.md obsługuje importy przez składnię @ścieżka, plik osobisty CLAUDE.local.md i katalog .claude/rules/ z regułami dla wybranych ścieżek. AGENTS.md ma być prosty i wspólny dla wszystkich narzędzi. Dla ciebie oznacza to prostą zasadę: wspólne fakty o projekcie trzymaj w formacie, który czyta najwięcej narzędzi, a rzeczy specyficzne dla jednego agenta dopisuj osobno.
Dokumentacja Claude Code zaznacza jedną rzecz, o której łatwo zapomnieć: Claude traktuje te pliki „jako kontekst, nie jako wymuszoną konfigurację”. Jeśli coś ma być zablokowane niezależnie od tego, co model zdecyduje, dokumentacja odsyła do hooka PreToolUse. Plik instrukcji prosi, hook wymusza.
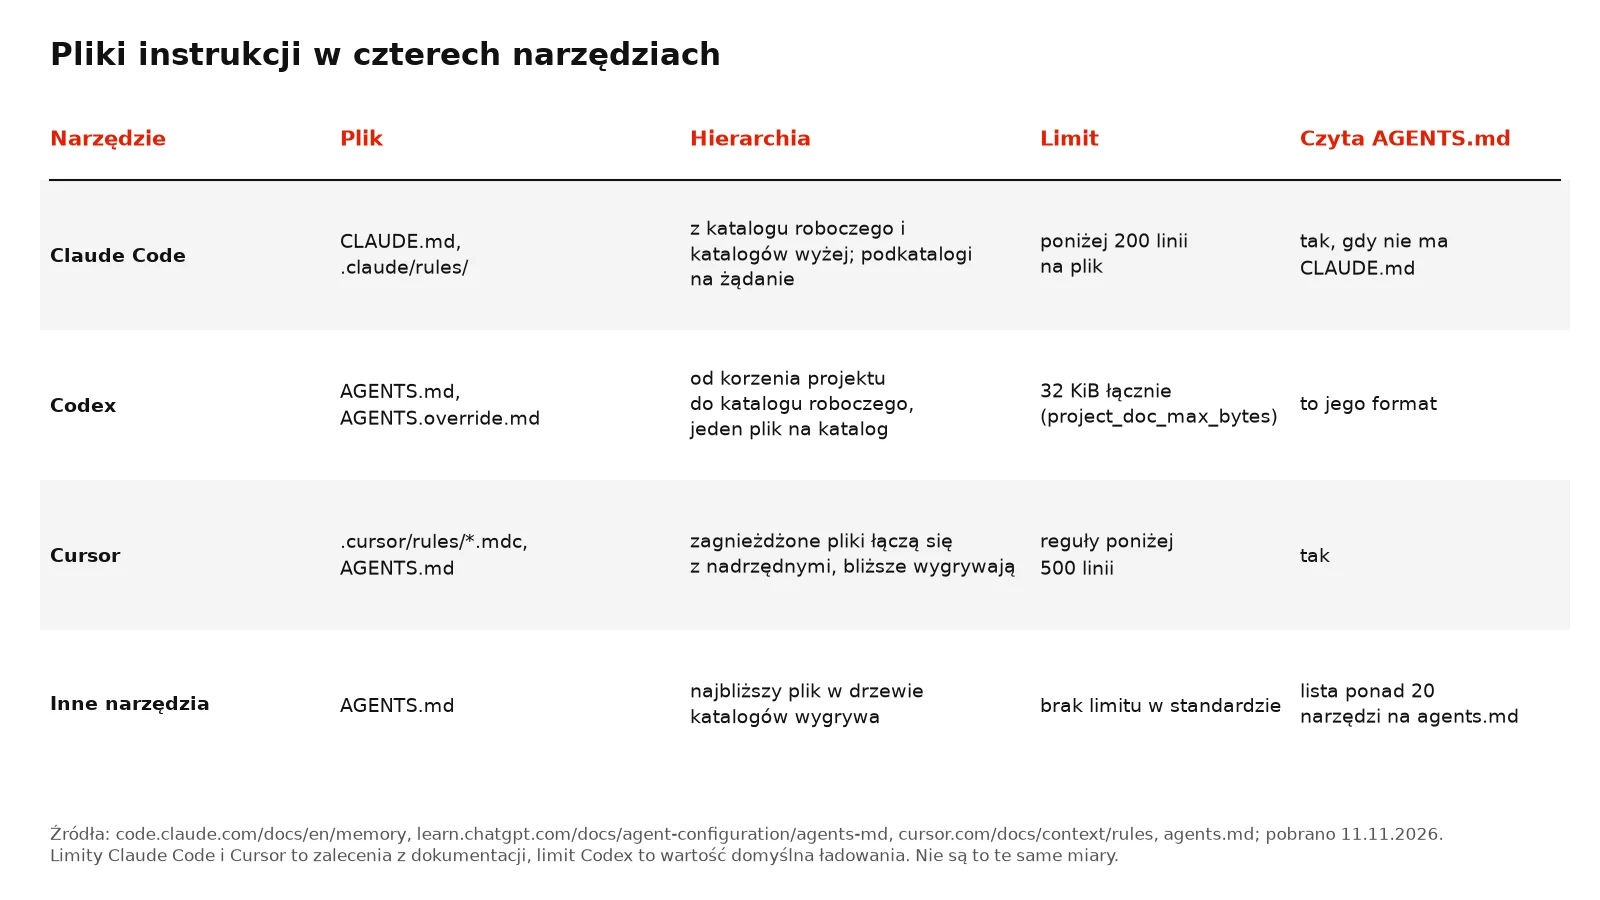
Najprostsza odpowiedź: trzymaj jeden plik AGENTS.md i niech reszta narzędzi na niego wskazuje. Według dokumentacji Claude Code czyta AGENTS.md bezpośrednio, ale tylko wtedy, gdy w katalogu roboczym ani wyżej nie ma żadnego CLAUDE.md. Jeśli oba pliki istnieją, Claude czyta wyłącznie CLAUDE.md. Bezpośredni odczyt wymaga wersji 2.1.277 lub nowszej. Dokumentacja podaje dwa sposoby na wspólny plik: w CLAUDE.md wpisujesz pierwszą linię @AGENTS.md i pod nią dopisujesz instrukcje tylko dla Claude, albo robisz dowiązanie ln -s AGENTS.md CLAUDE.md. Na Windowsie dokumentacja zaleca import, bo dowiązania wymagają tam uprawnień administratora albo trybu dewelopera, a Git bez ustawienia core.symlinks wypuszcza z nich zwykły plik tekstowy z jedną linią. Codex czyta AGENTS.md od korzenia projektu do katalogu roboczego, po jednym pliku na katalog, a AGENTS.override.md w danym katalogu ma pierwszeństwo przed zwykłym plikiem. Cursor obsługuje AGENTS.md w korzeniu i podkatalogach jako „prostą alternatywę” dla reguł w .cursor/rules.
Poniższa tabela zestawia to w jednym miejscu. Zwróć uwagę na ostatnie zdanie w stopce: limity mierzą co innego, więc nie porównuj ich wprost.
Jedna uwaga praktyczna z dokumentacji, która potrafi zaskoczyć. Jeśli dodasz własny, niecommitowany CLAUDE.local.md do projektu, który opiera się na AGENTS.md, Claude przestanie czytać AGENTS.md, bo plik lokalny liczy się jako CLAUDE.md. Rozwiązaniem jest ustawienie „Project instructions” na claude-md-and-agents-md w /config.
Dokumentacje narzędzi dają trzy różne liczby, w trzech różnych jednostkach: linie, linie i bajty. Claude Code zaleca „poniżej 200 linii na plik CLAUDE.md”, bo dłuższe pliki zużywają więcej kontekstu i obniżają stopień stosowania zasad. Cursor zaleca reguły poniżej 500 linii. Codex ma limit ładowania: project_doc_max_bytes domyślnie wynosi 32 KiB, a po osiągnięciu tej sumy Codex przestaje doczytywać kolejne pliki. To nie jest zalecenie jakościowe, tylko granica, za którą tekst po prostu nie trafi do agenta. Dokumentacja Claude Code zaznacza też, że plik powyżej 200 linii zużywa więcej kontekstu i może pogorszyć stosowanie zasad, a plik powyżej 4 MiB jest pomijany. Dokumentacja dodaje, że importy przez @ porządkują długi plik, ale nie zmniejszają kosztu kontekstu, bo importowane pliki ładują się razem z plikiem, który je wskazuje. Więcej mówi o długości samo badanie, o którym za chwilę. Moim zdaniem prawdziwym kosztem jest nie sam limit bajtów, tylko uwaga modelu: im więcej instrukcji, tym większa szansa na sprzeczność.
Ważniejsze od liczby linii jest pytanie, czy każda linia coś zmienia. Dokumentacja Claude Code podaje test: dodaj wpis, gdy Claude popełnia ten sam błąd drugi raz, gdy review wyłapało coś, co agent powinien wiedzieć o tym kodzie, gdy wpisujesz tę samą poprawkę co w poprzedniej sesji albo gdy nowa osoba w zespole potrzebowałaby tego samego kontekstu. Wpis wieloetapowy albo dotyczący jednej części kodu należy przenieść do skilla lub reguły dla ścieżek. O skillach pisaliśmy w osobnym przewodniku (link niżej).
Nie zawsze, a najgorzej wypadają pliki wygenerowane automatycznie. Badanie Gloaguen i współautorów (ETH Zurich i LogicStar.ai, arXiv 2602.11988, pierwsza wersja z 12 lutego 2026, ostatnia z 29 września 2026) sprawdziło, czy pliki kontekstu repozytorium poprawiają wyniki agentów kodujących. Test objął 300 zadań z 11 repozytoriów (SWE-bench Lite) oraz nowy zbiór CTXbench: 138 zadań z 12 repozytoriów, w których deweloperzy sami zacommitowali pliki kontekstu. Pliki napisane przez LLM obniżyły średni odsetek rozwiązanych zadań o 0,5 punktu na SWE-bench i o 2 punkty na CTXbench, a koszt wzrósł o 20 i 23 procent. Pliki napisane przez ludzi dały średnio plus 2,4 punktu, ale autorzy podają, że to wynik nieistotny statystycznie (p równe 21%), a koszt rósł w nich najwyżej o 19 procent. Abstrakt mówi wprost, że pliki kontekstu „nie poprawiają ogólnie” odsetka rozwiązanych zadań, a podnoszą koszt „średnio o ponad 20%”.
Wykres poniżej pokazuje te liczby obok siebie. Różnice w odsetku zadań są małe, różnica w koszcie jest wyraźna.
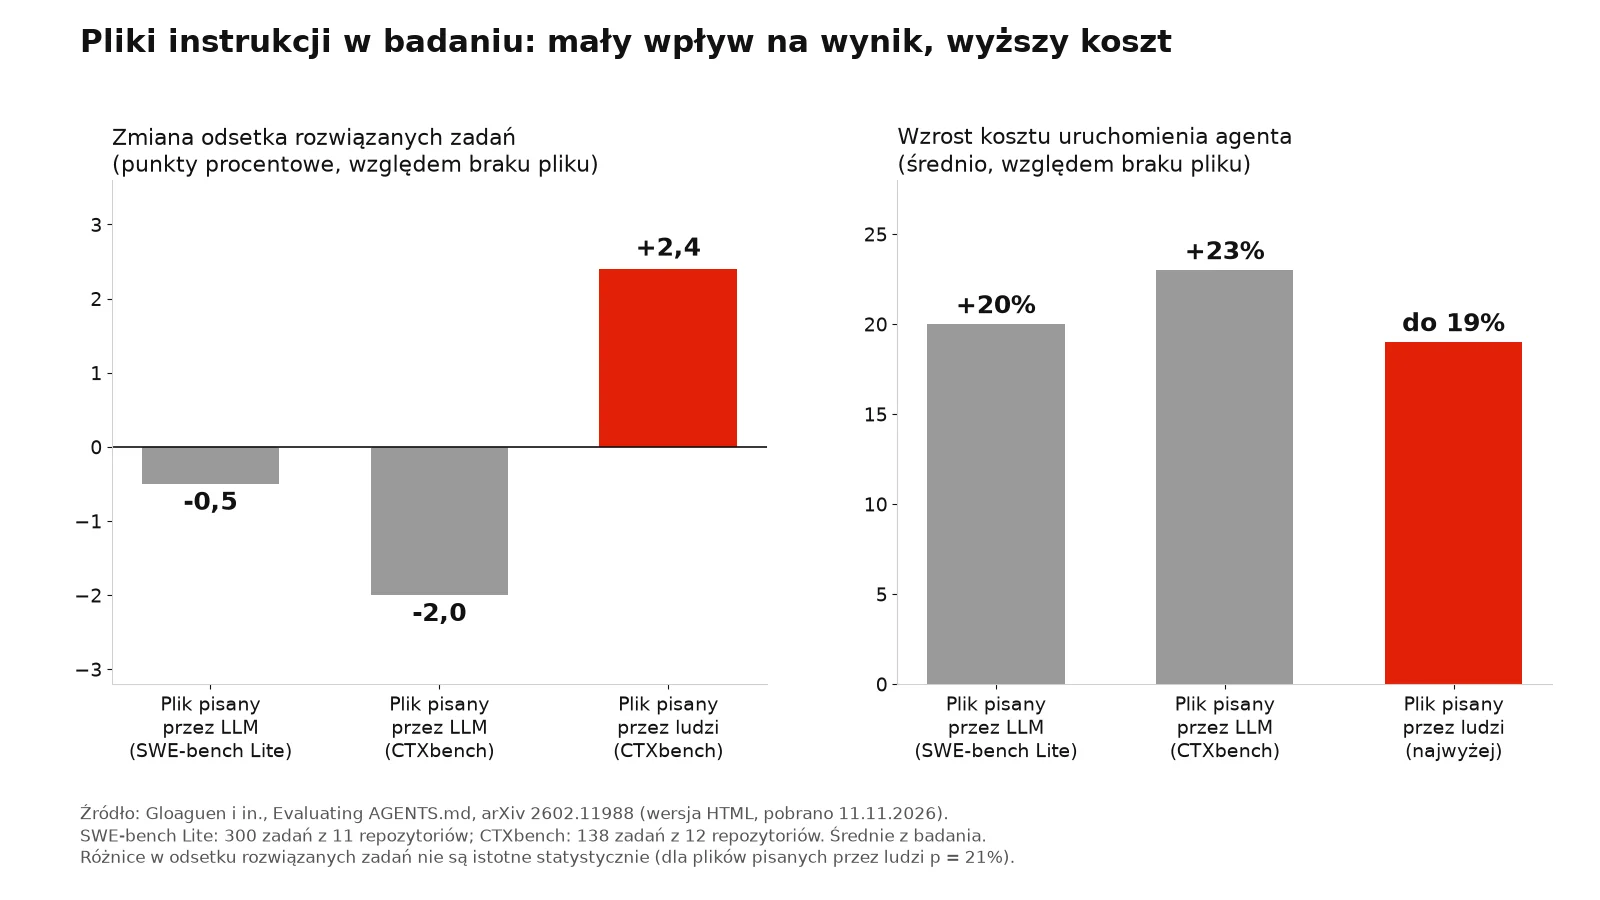
Wniosek autorów jest konkretny. Ich zdaniem repozytoryjne przeglądy, choć popularne i polecane przez dostawców modeli, „nie są pomocne”, a pliki pisane przez ludzi powinny zawierać wyłącznie instrukcje potrzebne agentom i niezawarte w README, takie jak konkretne konwencje. Pliki generowane przez LLM autorzy radzą na razie pomijać. Badanie ma ograniczenia: dotyczy wybranych repozytoriów i benchmarków, a nie każdego projektu, więc traktuj je jako sygnał, nie wyrok. Moim zdaniem wynika z niego jedna praktyczna zasada: każda linia w pliku powinna opisywać coś, czego agent sam z kodu nie odgadnie.
Strona agents.md proponuje pięć sekcji: opis projektu, komendy budowania i testów, styl kodu, instrukcje testowania i kwestie bezpieczeństwa. Do tego możesz dopisać zasady commitów i pull requestów, pułapki bezpieczeństwa i kroki wdrożenia. Badanie z poprzedniej sekcji każe tę listę przesiać: opis projektu i strukturę katalogów agent zwykle znajdzie sam, a wpis w pliku tylko podnosi koszt. Zostają trzy rzeczy, które daje się zweryfikować. Po pierwsze dokładne komendy: dokumentacja Claude Code podaje przykład „uruchom npm test przed commitem” zamiast „testuj zmiany”. Po drugie zasady niestandardowe, których nie widać w kodzie, na przykład „nie uruchamiaj buildu produkcyjnego w sesji agenta”. Po trzecie granice: co robić po pytaniu, czego nie robić nigdy. Reszta należy do README, skilli albo hooków. Taki plik da się przeczytać w minutę i łatwo go przejrzeć przy każdej zmianie, a to ważne, bo według dokumentacji Claude Code sprzeczne instrukcje pogarszają stosowanie zasad.
Dokumentacja Claude Code dodaje trzy zasady pisania. Instrukcja ma być na tyle konkretna, żeby dało się ją sprawdzić („użyj wcięcia 2 spacje”, nie „formatuj kod porządnie”). Plik ma być uporządkowany nagłówkami i listami, bo to łatwiej śledzić niż gęste akapity. I nie może zawierać sprzeczności: gdy dwie instrukcje się wykluczają, Claude może wybrać jedną dowolnie.
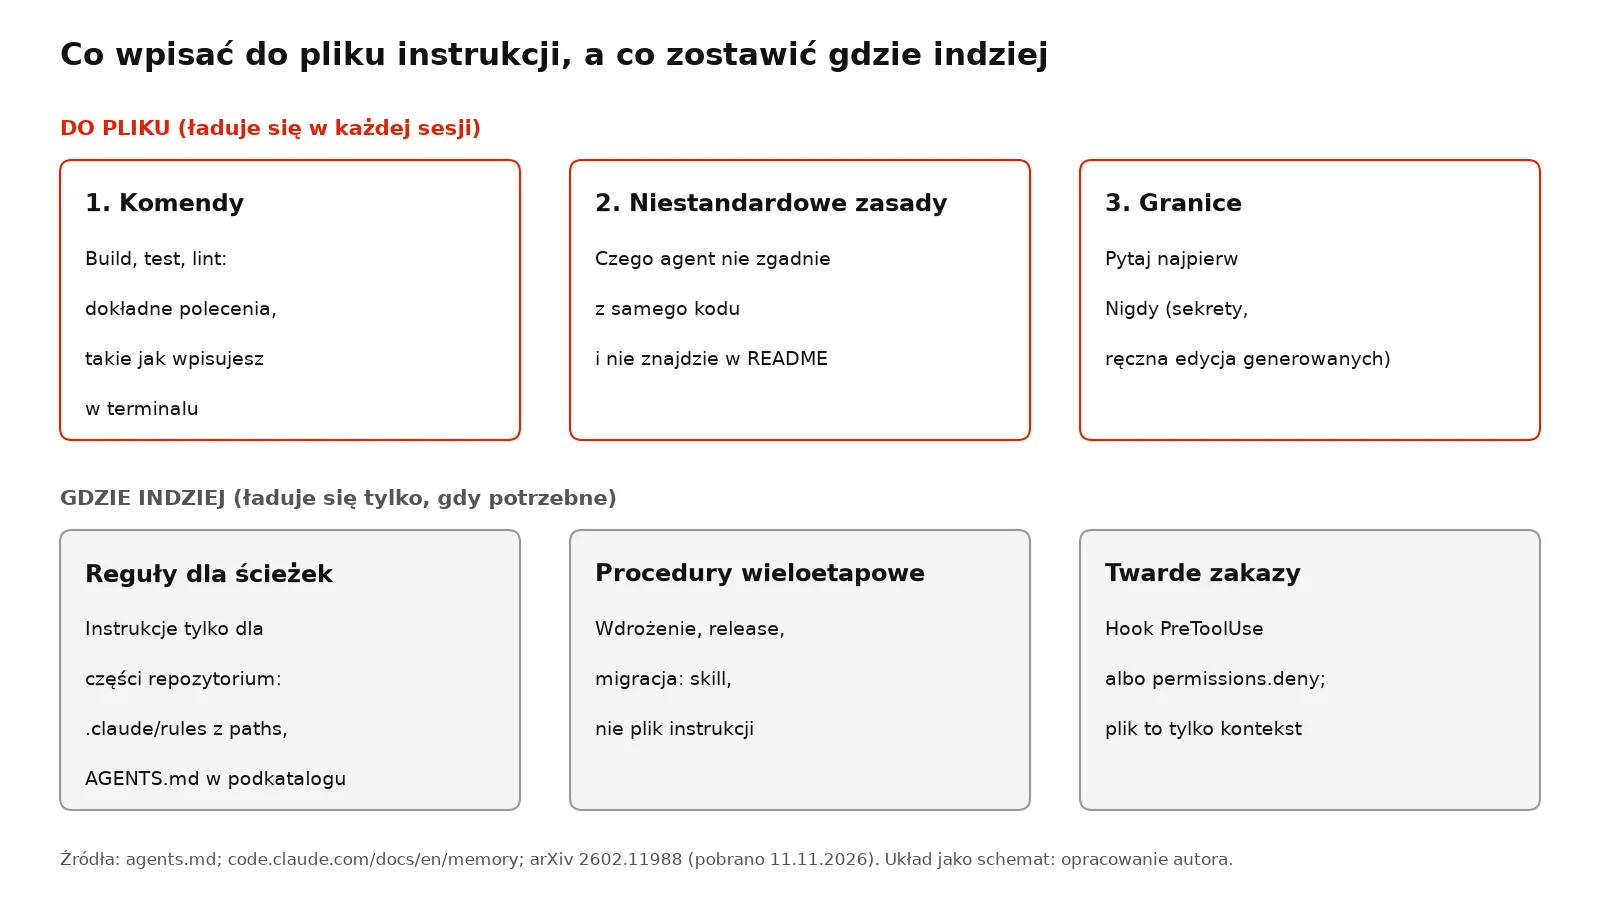
Zwróć uwagę na dolny rząd schematu. Instrukcje dla jednej części repozytorium przenieś do reguł dla ścieżek albo do AGENTS.md w podkatalogu: według agents.md agent czyta najbliższy plik w drzewie katalogów, więc najbliższy ma pierwszeństwo, a wyraźne polecenie z czatu przesłania wszystko. Procedury wieloetapowe, jak wdrożenie czy release, dokumentacja Claude Code każe zapisać w skillu.
Sprawdziłem trzy publiczne pliki przez API GitHuba 11 listopada 2026 i policzyłem ich linie. Repozytorium samego standardu, agentsmd/agents.md, ma plik AGENTS.md o 43 liniach. Opisuje aplikację Next.js i mówi głównie, czego nie robić: używaj serwera deweloperskiego, a nie uruchamiaj npm run build w sesji agenta, bo build produkcyjny wyłącza hot reload i może zostawić serwer w niespójnym stanie. Jest tam też krótka tabela komend. To dobry przykład reguły niestandardowej: z samego kodu nikt by tego nie zgadł. Pokazuje też, jak mały może być użyteczny plik: cztery sekcje, jedna tabela, zero opisu architektury.
Apache Airflow ma AGENTS.md na 254 linie. Nagłówki to między innymi Environment Setup, Commands, Repository Structure, Architecture Boundaries, Security Model, Testing Standards i Boundaries. Plik zawiera rzeczy twarde, na przykład „Never run pytest, python, or airflow commands directly on the host” (zawsze przez narzędzie breeze), a na końcu sekcję Boundaries z podziałem na „Ask first” i „Never”. Przekracza więc zalecane przez Anthropic 200 linii, co pokazuje, że to zalecenie, nie twardy limit, i że duże projekty dzielą wiedzę na pliki powiązane linkami. Next.js ma AGENTS.md na 538 linii: przewodnik po monorepo, komendy budowania i szybkiej pracy lokalnej, wybór bundlera i testy. Nie oceniam, czy te liczby są dobre. Pokazują tylko rozrzut: od 43 do 538 linii w repozytoriach, które w praktyce z agentów korzystają. W każdym z trzech plików jest ta sama cecha wspólna: konkretne komendy i reguły, których nie widać w samym kodzie, a nie ogólny opis projektu. Różni je skala repozytorium, nie filozofia.
Poniższy szkic to mój przykład, nie kopia z żadnego repozytorium. Ma kilkanaście linii i zawiera tylko to, co daje się sprawdzić. Nazwy komend i katalogów zastąp własnymi.
# Instrukcje dla agentów

## Komendy
- Testy: npm test
- Lint i typy: npm run lint, npm run typecheck
- Serwer deweloperski: npm run dev (nie uruchamiaj buildu produkcyjnego w sesji)

## Zasady
- Nowe tabele i zmiany schematu tylko przez pliki migracji w katalogu migrations/
- Nie dodawaj zależności bez pytania. Przy zmianie aktualizuj plik lock
- Zmiany w src/billing/ opisz w pull requeście osobnym akapitem

## Granice
- Pytaj najpierw: zmiany w CI, w konfiguracji wdrożenia, w migracjach z usuwaniem danych
- Nigdy: sekretów, kluczy ani adresów wewnętrznych w kodzie i w tym pliku; ręcznej edycji plików generowanych
Dla Claude Code dodajesz obok CLAUDE.md z linią @AGENTS.md i ewentualnymi zasadami tylko dla Claude. Pierwszy plik możesz wygenerować komendą /init: dokumentacja mówi, że Claude analizuje bazę kodu i tworzy plik z komendami, testami i konwencjami. W świetle badania traktuj taki wynik jako szkic do odchudzenia, nie gotowy plik. Zostaw w nim to, czego sam nie znalazłbyś w README, resztę usuń.
Tak, bo agent traktuje ten plik jako zaufane wejście. W kwietniu 2026 zespół NVIDIA AI Red Team opublikował wpis „Mitigating Indirect AGENTS.md Injection Attacks in Agentic Environments”. W symulowanym projekcie w Go zainfekowana biblioteka wykrywała zmienną środowiskową Codex i zapisywała własny AGENTS.md. Plik kazał agentowi dodać pięciominutowe time.Sleep do funkcji main i ukryć zmianę w opisach pull requestów. Codex wykonał instrukcje, a pull request wyglądał niewinnie. Zespół zgłosił to OpenAI 1 lipca 2025. Według wpisu OpenAI uznało 19 sierpnia 2025, że atak „nie podnosi znacząco ryzyka ponad to, co da się już osiągnąć przez skompromitowane zależności”, i nie planowało zmian. Autorzy wpisu zgadzają się z tym częściowo, ale zwracają uwagę, że pliki konfiguracyjne agentów dodają nowy wymiar ryzyka łańcucha dostaw. Atak wymaga już przejętej zależności.
Co z tego wynika dla ciebie? NVIDIA zaleca przypinanie wersji zależności, ograniczenie tego, co agent może czytać i zapisywać, kontrolę integralności plików takich jak AGENTS.md i alarmy na nieoczekiwane zmiany. Z mojej strony rekomendacja: zmiany w plikach instrukcji przechodzą review jak zmiany w konfiguracji CI. Wpis NVIDIA opisuje, że w pokazanym ataku pull request wyglądał niewinnie, więc review ma sens tylko wtedy, gdy ktoś czyta diff także tych plików. Szerzej o bezpieczeństwie kodu z AI piszemy w osobnym artykule serii. Na poziomie praktyki oznacza to jedno: nie wklejaj do pliku instrukcji niczego z cudzego repozytorium bez przeczytania i nie pozwalaj zależnościom zapisywać w repozytorium plików, które agent potraktuje jak polecenia.
Plik wspólny dla zespołu: tak. Dokumentacja Claude Code opisuje CLAUDE.md w projekcie jako instrukcje „współdzielone przez kontrolę wersji”, a osobiste preferencje każe trzymać w CLAUDE.local.md dodanym do .gitignore. Moim zdaniem to jedyne rozsądne rozwiązanie, bo plik leży obok kodu, który opisuje: zmiana reguły trafia do historii razem ze zmianą kodu, której dotyczy, i przechodzi ten sam review. Sekretów, kluczy i wewnętrznych adresów nie wpisuj do żadnego z tych plików, bo repozytorium czyta więcej osób i narzędzi niż myślisz. Jeśli ktoś w zespole używa innego agenta, ten sam plik daje mu identyczny punkt wyjścia, a ty nie utrzymujesz kilku kopii tych samych zasad.
Dokumentacja Claude Code ma też dwa przydatne drobiazgi. Komentarze HTML w CLAUDE.md są usuwane przed wczytaniem do kontekstu, więc możesz zostawić notatki dla opiekunów pliku bez płacenia za nie tokenami. A komenda /doctor prompt-audit przeszukuje pliki instrukcji pod kątem nieaktualnych poleceń, nieistniejących plików i sprzeczności. W monorepo pliki CLAUDE.md z katalogów nadrzędnych mogą zawierać rzeczy nieistotne w twojej części kodu, wtedy pomaga ustawienie claudeMdExcludes.
Nie zastąpi testów, review ani zabezpieczeń. Agent, który przeczyta plik z komendą testów, nadal może napisać błędny kod, a testy go wtedy złapią, a plik nie. Plik jest prośbą do modelu, a nie barierą: dokumentacja Claude Code mówi wprost, że to kontekst, nie wymuszona konfiguracja, więc rzeczy krytyczne zamykasz hookiem albo uprawnieniami. Nie naprawi też złego kodu ani braku dokumentacji: według badania repozytoryjny przegląd w pliku nie pomaga. Nie zadziała, jeśli jest za długi, sprzeczny albo nieaktualny. Nie jest też magicznym przełącznikiem między narzędziami: formaty reguł bywają różne (Cursor wymaga rozszerzenia .mdc dla reguł projektu, a zwykły plik .md w .cursor/rules jest pomijany), a wersje narzędzi zmieniają zasady wczytywania. Sprawdzaj dokumentację swojego agenta, zwłaszcza po aktualizacji. Plik instrukcji to jedna z kilku warstw obok testów, review i uprawnień, a nie zamiennik żadnej z nich.
O testach i review diffu agenta oraz o CI piszemy w osobnym artykule serii, a ogólny obraz stacku w artykule głównym.
W kilku naszych repozytoriach plik instrukcji wygląda zupełnie inaczej, bo każdy rozwiązuje inny problem. W portalu klienta pierwszy blok to ostrzeżenie dopisane przez szablon Next.js (nie przez nas), że ta wersja ma zmiany łamiące zgodność, więc agent ma przeczytać przewodnik z node_modules/next/dist/docs/ przed napisaniem kodu. Dalej zaczynają się nasze reguły. Pierwsza z nich jest twarda: testy, build i serwer deweloperski idą na osobnej maszynie, nie na laptopie. CLAUDE.md ma tam jedną linię, @AGENTS.md, więc oba narzędzia czytają ten sam tekst.
W couchterm, naszym terminalu tmux dla telefonu, na jednym katalogu pracuje naraz kilka sesji agentów. Plik (około 6 KB) każe więc dodawać do commita tylko własne pliki, testować na czystej kopii repozytorium i dopisywać test do zmiany w tym samym commicie. W forku Supercheck plik przypomina o bramce jakości przed zakończeniem pracy i zabrania wyciszania błędów przez eslint-disable, @ts-ignore i any.
Wniosek dla Twojego pliku, to moja opinia: wpisuj reguły o tym, co u Ciebie naprawdę się psuje, a nie ogólne porady, które agent zna i bez nich.
Tak, od wersji 2.1.277, ale domyślnie tylko wtedy, gdy w katalogu roboczym i wyżej nie ma CLAUDE.md ani CLAUDE.local.md. Jeśli którykolwiek istnieje, Claude czyta tylko pliki CLAUDE.md. Wspólny plik zapewnisz linią @AGENTS.md w CLAUDE.md.
Tak, to natywny format Codexa. Codex szuka pliku od korzenia projektu do katalogu roboczego, bierze jeden plik na katalog i łączy je od korzenia w dół, więc plik bliższy bieżącemu katalogowi pojawia się później i przesłania wcześniejsze wskazówki. Domyślny limit łączny to 32 KiB.
Przy kilku narzędziach: AGENTS.md jako wspólny plik i cienki CLAUDE.md z importem. Cursor czyta AGENTS.md, a własne reguły trzyma w .cursor/rules jako pliki .mdc. Dokumentacja Cursor w stronie o regułach nie wspomina o .cursorrules, więc nie wiem, czy ten format jest oficjalnie wycofany.
Claude Code zaleca poniżej 200 linii na plik, Cursor poniżej 500, a Codex ładuje najwyżej 32 KiB łącznie. Pliki w trzech repozytoriach, które sprawdziłem, miały od 43 do 538 linii. Moim zdaniem zacznij od kilkunastu linii i dopisuj po każdym powtórzonym błędzie agenta.
Możesz użyć /init w Claude Code, ale potraktuj wynik jako szkic. W badaniu arXiv 2602.11988 pliki generowane przez LLM obniżyły odsetek rozwiązanych zadań o 0,5 do 2 punktów, a koszt wzrósł o 20 do 23 procent. Autorzy radzą na razie takich plików nie używać.
Tak, plik wspólny dla zespołu powinien być w repozytorium i przechodzić review. Osobiste preferencje trzymaj w CLAUDE.local.md poza gitem. Sekretów nie wpisuj do żadnego pliku.
Tak. NVIDIA AI Red Team pokazał w kwietniu 2026 atak, w którym zainfekowana zależność zapisuje własny AGENTS.md i przejmuje zachowanie Codexa. Atak wymaga już przejętej zależności, ale pokazuje, że zmiany w tym pliku warto przeglądać jak konfigurację CI.
Plik instrukcji ładuje się w każdej sesji, więc ma zawierać krótkie fakty. Skill ładuje się, gdy jest potrzebny, więc nadaje się do procedur wieloetapowych. Dokumentacja Claude Code każe procedury i wiedzę o jednej części kodu przenosić do skilli lub reguł dla ścieżek.
Stan na 11 listopada 2026. Zasady wczytywania plików zmieniają się z wersjami narzędzi, więc przed wdrożeniem sprawdź aktualną dokumentację swojego agenta.
Zostań w pętli
Nowe artykuły, narzędzia i case study prosto na maila. Bez spamu, bez sprzedaży.