AI i Automatyzacje
Kod od agenta zachowuje jakość wtedy, gdy każda zmiana przechodzi tę samą drogę: mały pull request, testy odpalane automatycznie, przeczytany diff i merge możliwy dopiero po zielonych, wymaganych statusach. Agent pisze szybko, więc bramki muszą działać bez Twojej pamięci: hooki, GitHub Actions, ochrona gałęzi i Dependabot.
Łukasz Ślusarski, important.is. Stan na 11 listopada 2026. Opracowane na podstawie raportu DORA 2025, dokumentacji GitHub oraz dokumentacji Claude Code i Codex.
Agent kodujący potrafi w krótkim czasie dostarczyć więcej zmian, niż człowiek jest w stanie rzetelnie przejrzeć. Raport DORA z 2025 roku pokazuje, co z tego wynika: AI poprawia przepustowość dostarczania, ale nadal zwiększa niestabilność, czyli odsetek wdrożeń kończących się poprawką albo cofnięciem zmian. Szybkość sama się nie zamienia w jakość, trzeba ją przepuścić przez bramki.
Ten tekst jest dla osób, które trzymają kod na GitHubie i zlecają jego pisanie agentom, na przykład Claude Code albo Codex. Nie porównuję narzędzi i nie omawiam sekretów ani luk w zabezpieczeniach, to jest w osobnym artykule o bezpieczeństwie kodu z AI. Tutaj chodzi o jakość: czy zmiana robi to, co miała robić, i czy ktoś ją potem utrzyma. U nas build jest częścią komendy npm run verify, bo zielone testy nie wykryły błędu, który położył portal (opis na końcu).
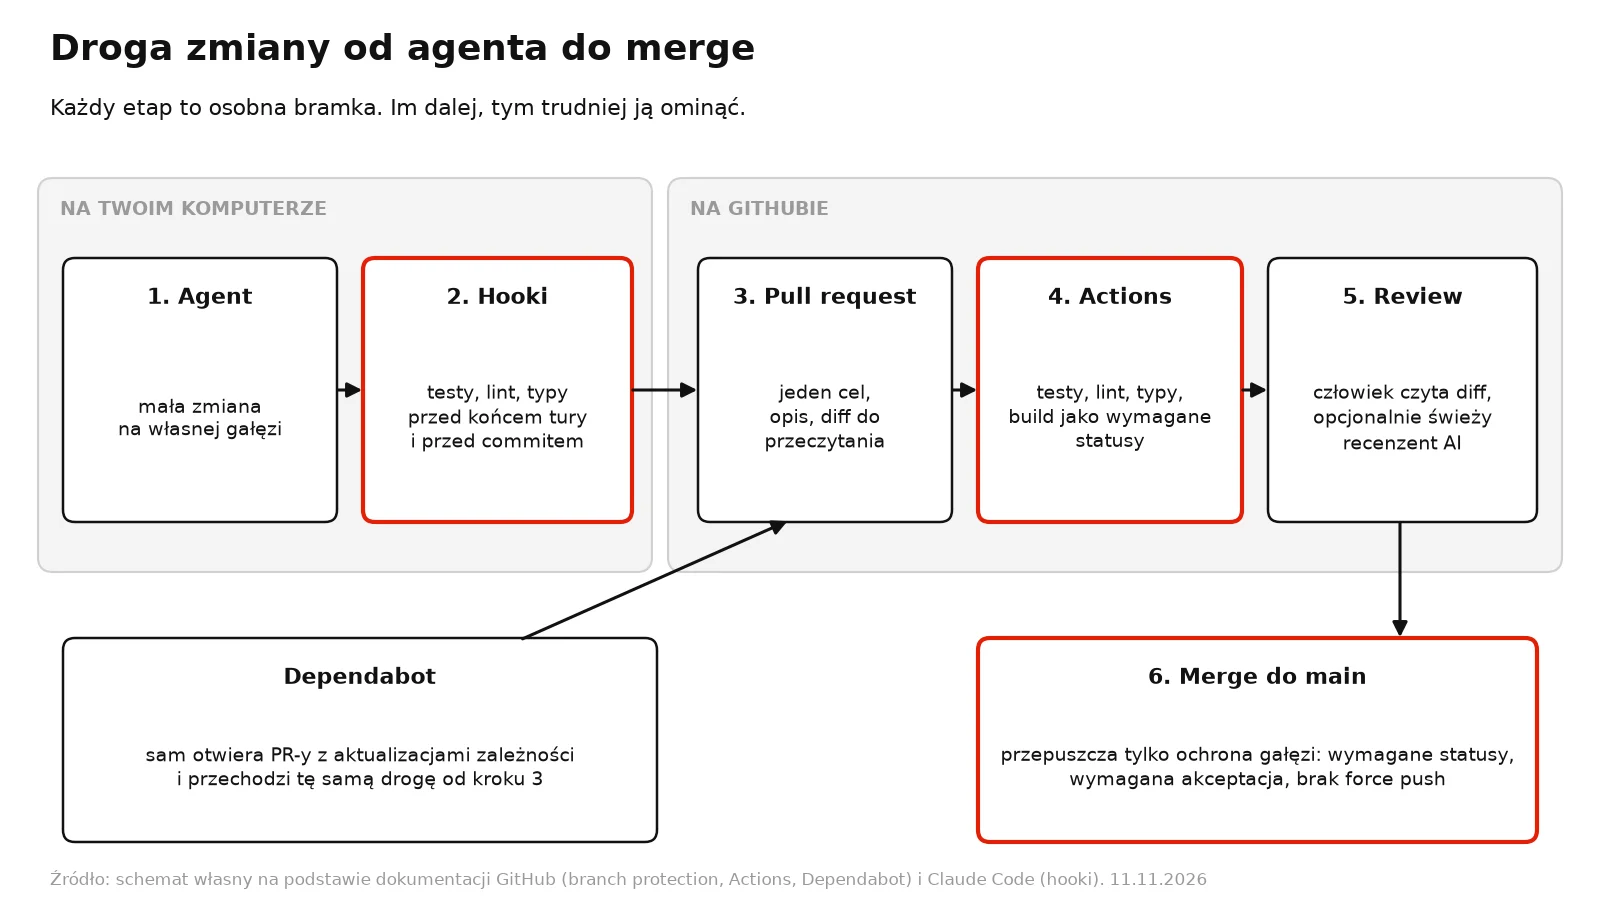
Poniższa tabela zbiera siedem elementów, które opisuję dalej. Schemat pod nią pokazuje, w jakiej kolejności zmiana przez nie przechodzi.
| Element | Co ustawić | Co to daje |
|---|---|---|
| Mały pull request | Jeden cel, zmiana do przeczytania w jednym posiedzeniu | Review, które da się zrobić uważnie |
| Testy | Przed kodem dla błędów i logiki, po kodzie dla prototypów | Agent dostaje wynik pass lub fail |
| Hooki agenta | Stop lub PostToolUse uruchamiające testy i lint | Agent sam poprawia, zanim zgłosi koniec |
| GitHub Actions | Testy, lint, typy i build jako wymagane statusy | Sprawdzenie na czystym środowisku, nie na Twoim komputerze |
| Ochrona gałęzi | Wymagane statusy i akceptacja, zakaz force push | Merge nie omija bramek |
| Dependabot | Plik dependabot.yml w repozytorium | Aktualizacje zależności jako małe pull requesty |
| Review diffu | Najpierw testy, potem kod | Decyzja człowieka tam, gdzie automat jej nie podejmie |
Schemat pokazuje drogę jednej zmiany. Dwie bramki na czerwono, hooki i Actions, to te, które sprawdzają kod bez udziału człowieka. Reszta wymaga decyzji.
Zrobić to razem?
Wdrażam takie rzeczy w firmach na co dzień. Umów 30 minut, pogadamy konkretnie o Twoim przypadku. Bez prezentacji sprzedażowej.
Umów bezpłatną rozmowę →
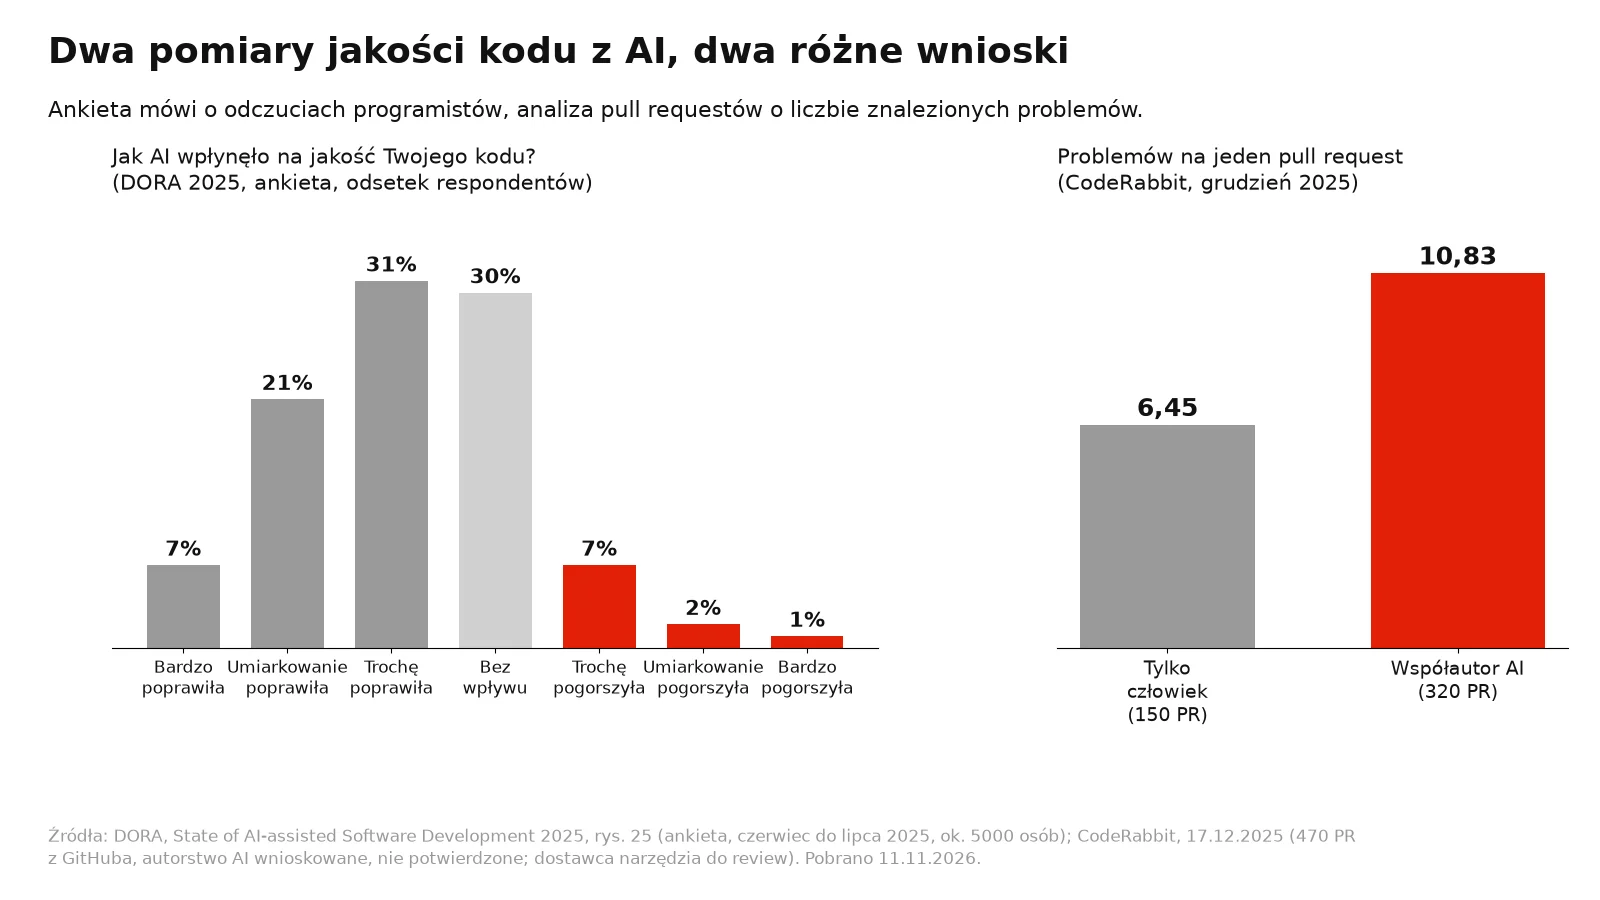
Dane są mieszane i zależą od tego, kogo pytasz. W ankiecie DORA 2025 z udziałem prawie 5000 osób 59 procent respondentów uznało, że AI poprawiło jakość ich kodu, a 10 procent, że ją pogorszyło. Z drugiej strony CodeRabbit przeanalizował 470 pull requestów z GitHuba i naliczył średnio 10,83 problemu na pull request ze współautorem AI wobec 6,45 przy pracy samego człowieka, czyli około 1,7 raza więcej. To dwa różne pomiary: pierwszy to odczucia, drugi to liczba znalezionych problemów. Autorzy drugiego przyznają, że autorstwo wnioskowali, więc nie ma pewności, że wszystkie pull requesty „ludzkie” napisał wyłącznie człowiek. Rozsądny wniosek: kod od agenta bywa dobry i bywa gorszy, a nie wiesz z góry, który przypadek masz przed sobą, więc sprawdzasz go zawsze. Obie liczby opisują stan z 2025 roku, a modele i narzędzia zmieniają się szybciej niż raporty.
Wykres zestawia oba pomiary obok siebie. Lewy panel to rozkład odpowiedzi z ankiety DORA, prawy to średnia liczba problemów z raportu CodeRabbit.
Raport CodeRabbit rozbija wynik na kategorie. Błędy logiki i poprawności były w pull requestach z AI częstsze o 75 procent, problemy z czytelnością ponad trzykrotnie, a luki w obsłudze błędów prawie dwukrotnie. Autorzy zaznaczają, że żadna kategoria nie jest unikalna dla AI: agent robi te same błędy co człowiek, tylko częściej. Pamiętaj też, że CodeRabbit sprzedaje narzędzie do review, więc ma interes w takim wyniku. Drugi, niezależny sygnał dotyczy struktury kodu. GitClear przeanalizował 211 milionów zmienionych linii z lat 2020 do 2024 i podaje, że udział linii „przeniesionych”, czyli śladu refaktoryzacji, spadł z 25 procent w 2021 roku do poniżej 10 procent w 2024, a udział kopiowanego kodu w tym samym czasie wzrósł z 8,3 do 12,3 procent. Raport opisuje trend z okresu, w którym asystenci się upowszechnili. Nie dowodzi, że winna jest sama AI, i nie sprawdzałem, jak rozpoznano kod z AI.
Testy przed kodem piszesz wtedy, gdy potrafisz opisać oczekiwane zachowanie w kilku zdaniach: naprawa błędu, funkcja z jasnym wejściem i wyjściem, kontrakt API, przeliczanie cen lub dat. Test jest wtedy specyfikacją, a agent dostaje wynik pass lub fail, z którym może pracować sam. Dokumentacja Claude Code radzi dokładnie to: zamiast „napraw błąd logowania” napisać polecenie, które każe znaleźć miejsce w kodzie, napisać test odtwarzający błąd i dopiero potem go naprawić. Badanie Mathewsa i Nagappana z 2024 roku, na modelach GPT-4 i Llama 3 oraz zestawach MBPP i HumanEval, wykazało, że dołączenie testów do opisu zadania zwiększa odsetek poprawnie rozwiązanych zadań. Testy po kodzie są uczciwym wyborem przy prototypie, układzie interfejsu albo eksploracji, gdy nie wiesz jeszcze, czego chcesz. Zasada jest jedna: żadna zmiana nie wchodzi do głównej gałęzi bez testu, który padłby, gdyby kod był błędny.
Jest pułapka, której nie znalazłem w przeczytanych dokumentacjach, więc to moja opinia, nie ustalenie ze źródła. Gdy ten sam agent pisze kod i test w jednej sesji, test łatwo staje się opisem tego, co kod robi, a nie tego, co ma robić. Agent, któremu test nie przechodzi, może też poprawić test zamiast kodu. Dlatego przy review czytam diff testów przed diffem kodu i pytam jedno: czy ten test padłby, gdyby kod był zły? Sprawdzam też, czy agent nie zmienił istniejącego testu, żeby zmieścić się w zielonym wyniku. Zmiana asercji w istniejącym teście zasługuje na osobne pytanie w komentarzu.
Daj agentowi także komendy testów w pliku z instrukcjami. Dokumentacja Claude Code nazywa to najbardziej użyteczną linią w CLAUDE.md, jeśli repozytorium ma już coś, co zwraca pass lub fail. Jak taki plik napisać, opisuję w artykule o AGENTS.md i CLAUDE.md.
Czytaj od testów, potem od interfejsów, na końcu od implementacji. Najpierw pytasz, co zmiana ma robić i czy testy to potwierdzają. Potem sprawdzasz, co zmieniło się na granicach: sygnatury funkcji, schemat bazy, zmienne konfiguracyjne, nowe zależności. Dopiero na końcu czytasz środek. Dokumentacja Claude Code zaleca, by o dowód prosić wprost: o komendę, którą agent uruchomił, i jej wynik, bo samo „testy przechodzą” mówi mało. Dla recenzji innym okiem opisuje polecenie code-review, które sprawdza diff w świeżym subagencie niewidzącym wcześniejszej rozmowy, więc nie ulega rozumowaniu, które ten kod wytworzyło. Codex ma analogiczne polecenie codex review z trzema celami: zmiany niezatwierdzone, zmiany względem gałęzi bazowej i konkretny commit. Pytanie, które zadaję przy każdej zmianie: co zniknie, jeśli to wycofam, i czy ktoś to zauważy. Jeśli diff jest za duży na takie czytanie, to znak, by wrócić do agenta z prośbą o podział, a nie by czytać szybciej.
Dwie uwagi praktyczne. Po pierwsze, recenzent AI zawsze coś znajdzie. Dokumentacja Claude Code ostrzega, że recenzent proszony o szukanie problemów zawsze coś zwróci, a naprawa każdego znaleziska kończy się zbędnymi warstwami abstrakcji i testami przypadków, które nie mogą wystąpić. Dlatego w prompcie zostaw zdanie o pominięciu stylu i każ sprawdzać zmianę względem specyfikacji. Po drugie, możesz dać recenzentowi tylko prawa odczytu: dokumentacja pokazuje subagenta z narzędziami Read, Grep i Glob, który nie może niczego edytować, a ograniczenie wymusza Claude Code, nie prompt.
Bo duży diff nie podlega uważnemu review, a agent bez ograniczenia może produkować duże. Raport DORA 2025 stawia hipotezę, że niestabilność rośnie przy AI w części dlatego, że trudniej recenzować większe porcje kodu. Zarazem znajduje z dużą pewnością, że praca małymi porcjami wzmacnia wpływ AI na wyniki produktu i zamienia neutralny wpływ na tarcie w korzystny. Wynik dla indywidualnej skuteczności jest lekko ujemny, bo AI głównie daje poczucie szybkiego wygenerowania dużo kodu, ale autorzy oceniają bilans jako dodatni. Strona DORA o małych porcjach przyjmuje, że zmiana powinna zająć od kilku godzin do paru dni, a ponad tydzień to już za dużo. Nie znalazłem w DORA progu w liczbie linii, więc go nie podaję. Raport mierzy małe porcje trzema wskaźnikami: liczbą linii w ostatniej zmianie, liczbą zmian w jednym wydaniu i czasem potrzebnym na zadanie.
W praktyce: jedno zadanie dla agenta to jeden cel i jedna gałąź, a polecenie zawiera granicę („tylko moduł płatności, bez zmiany schematu bazy”). Gdy agent rozrasta zmianę, przerywasz i dzielisz ją na dwie. Do tego dochodzi częsty commit: według DORA zalety AI dla indywidualnej skuteczności są większe tam, gdzie zespoły commitują często, a częste użycie cofania zmian wzmacnia wpływ AI na wyniki zespołu. Repozytorium działa jak siatka bezpieczeństwa, ale tylko jeśli faktycznie cofasz.
Workflow w GitHub Actions uruchamia testy, lint, sprawdzanie typów i build na każdym pull requeście, a potem oznaczasz te zadania jako wymagane statusy w ochronie gałęzi (na planie Free ochrona gałęzi działa w repozytoriach publicznych, w prywatnych wymaga planu Pro, Team lub Enterprise). Samo uruchamianie niczego nie blokuje, blokuje dopiero wymóg. Zmiana jest sprawdzana w czystym środowisku, a nie na komputerze, na którym agent mógł zostawić ustawienia i pliki. Raport DORA zauważa, że niezależnie od tego, czy kod napisał człowiek czy AI, stosuje się te same zautomatyzowane testy i wdrożenia, które mają zapewnić bezpieczeństwo zmian. Trzy rzeczy z dokumentacji GitHub zaoszczędzą Ci kłopotów. Żeby wybrać zadanie jako wymagany status, musiało ono zakończyć się sukcesem w repozytorium w ciągu ostatnich siedmiu dni. Workflow pomijany przez filtr ścieżek, filtr gałęzi lub wiadomość commita zostaje w stanie Pending i blokuje merge, więc GitHub odradza wymagania workflow, który można pominąć. Zadanie pominięte przez warunek zgłasza natomiast sukces. Do tego kluczem permissions ograniczasz uprawnienia tokenu GITHUB_TOKEN do tego, czego zadanie potrzebuje, a concurrency pilnuje, by nie biegły równolegle dwa przebiegi tej samej grupy.
Polecam prosty zestaw: jedno zadanie na testy, jedno na lint i typy, jedno na build, wszystkie wywoływane przez pull_request. Nie uruchamiaj dodatkowych kontroli tylko dla zmian agenta: te same reguły dla wszystkich są łatwiejsze do utrzymania i do wyjaśnienia.
Tak, jeśli aplikacja ma ścieżki, których nie sprawdzi ani test jednostkowy, ani build: logowanie, formularz, zapis i odczyt danych. Playwright uruchamia prawdziwą przeglądarkę i przeklikuje aplikację, a przy inicjalizacji projektu (npm init playwright@latest) możesz poprosić o gotowy plik .github/workflows/playwright.yml. Według dokumentacji taki workflow uruchamia się przy push i pull requeście do gałęzi main lub master, instaluje przeglądarki, uruchamia testy i zapisuje raport HTML jako artefakt, przechowywany 30 dni. Dokumentacja zaleca też jednego workera w CI, dla stabilności i powtarzalności wyników. Moja rada: dodaj testy end-to-end jako osobne zadanie i oznacz je jako wymagany status dopiero wtedy, gdy przechodzą stabilnie, bo test, który pada bez powodu, uczy wszystkich klikać „merge mimo wszystko”. U nas Playwright jest miarą przy przepisywaniu frontu Sherpy na React: te same testy uruchamiamy na starej i nowej wersji, a przełączenie następuje dopiero po ich przejściu.
Ochrona gałęzi jest jedyną bramką, której agent nie ominie przypadkiem, bo działa po stronie GitHuba. Dokumentacja wymienia opcje, które mają tu znaczenie: wymagane przeglądy przed merge, odrzucanie nieaktualnych akceptacji po nowych commitach, wymagane statusy, wymóg aktualności gałęzi względem bazowej, rozstrzygnięcie wszystkich rozmów, wymóg liniowej historii, kolejka merge, force push (domyślnie wyłączony) i zakaz usuwania gałęzi. Jest też ustawienie blokujące obejście reguł przez osoby z uprawnieniami. Wymóg liniowej historii zablokuje merge commity i wymaga włączonego squasha lub rebase. Alternatywą dla pojedynczej reguły są rulesets: można ich nałożyć kilka na tę samą gałąź, a przy sprzeczności obowiązuje wersja ostrzejsza. Według dokumentacji rulesets dotyczą planów GitHub Team i Enterprise, więc przy darmowym koncie sprawdź dostępność. Ochrona zadziała tylko na gałęziach, które reguła obejmuje, więc po ustawieniu sprawdź na próbnym pull requeście w tym samym repozytorium, czy merge faktycznie się blokuje.
Moja rekomendacja polityki, to opinia: merge przez squash, żeby jedna zmiana oznaczała jeden commit do cofnięcia; wymagane statusy z Actions; co najmniej jedna akceptacja człowieka tam, gdzie pracuje więcej niż jedna osoba; odrzucanie nieaktualnych akceptacji; zakaz force push i usuwania głównej gałęzi; bez wyjątków dla administratorów. Auto-merge, czyli scalenie po spełnieniu wymaganych przeglądów i statusów, pojawia się tylko przy pull requestach, których nie da się scalić od razu, więc wymaga ochrony gałęzi. Włączaj go dla zmian, które po zielonych testach nie wymagają decyzji, na przykład drobnych aktualizacji zależności. Dla zmian agenta w logice biznesowej zostaw merge ręczny.
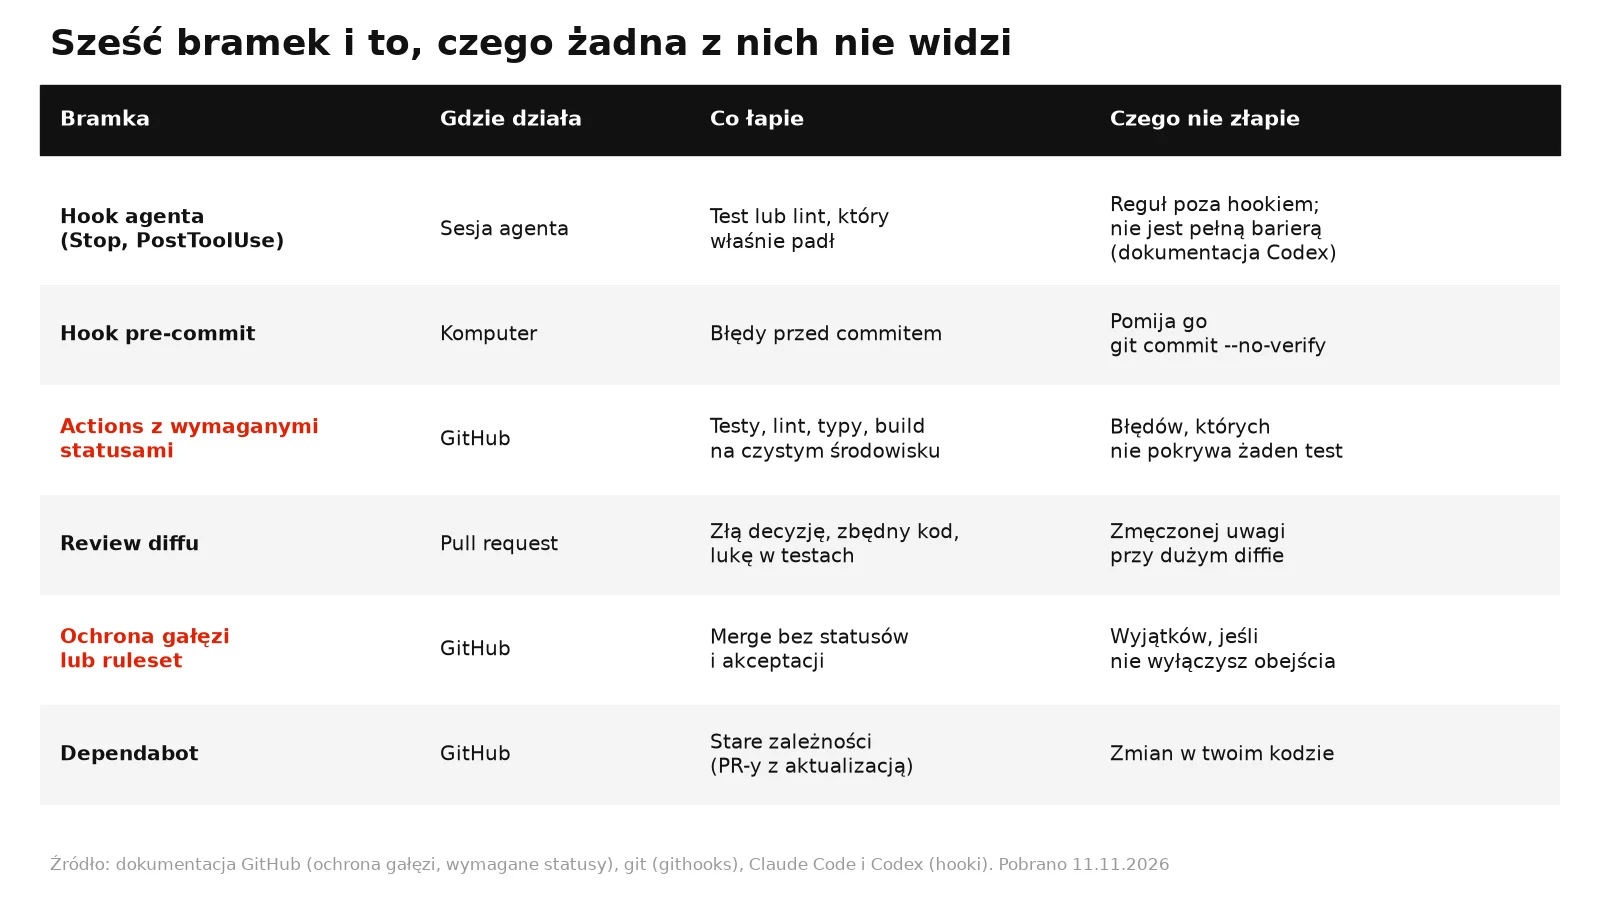
Tabela poniżej zestawia wszystkie bramki z tym, co każda łapie i czego nie widzi. Żadna nie jest kompletna, dlatego działają razem.
Hook to skrypt uruchamiany automatycznie w ustalonym punkcie pracy agenta, więc reguła działa niezależnie od tego, czy model ją pamięta. W Claude Code hooki konfiguruje się w pliku settings.json, a zdarzenia obejmują między innymi PreToolUse przed wywołaniem narzędzia, PostToolUse po nim i Stop, gdy agent próbuje zakończyć turę. Kod wyjścia 2 jest błędem blokującym: przy PreToolUse blokuje wywołanie, przy PostToolUse pokazuje agentowi stderr, bo narzędzie już zadziałało, a przy Stop odsyła agenta do pracy. Dokumentacja podaje limit: gdy hook zablokuje osiem zakończeń z rzędu bez wywołania narzędzia, Claude Code przerywa blokowanie. Codex ma podobny model: hooki w hooks.json lub w config.toml, w katalogu użytkownika albo w repozytorium, zdarzenia PreToolUse, PostToolUse i Stop, a hook Stop z decyzją block każe Codexowi kontynuować. Dokumentacja Codex dodaje jednak trzeźwo, że hooki narzędzi to „użyteczna poręcz, a nie kompletna granica wymuszania” (tłumaczenie moje).
Przykład z dokumentacji Claude Code uruchamia skrypt po każdej edycji lub zapisie pliku:
{
  "hooks": {
    "PostToolUse": [
      {
        "matcher": "Edit|Write",
        "hooks": [
          {
            "type": "command",
            "command": "${CLAUDE_PROJECT_DIR}/.claude/hooks/run-checks.sh",
            "args": [],
            "timeout": 120
          }
        ]
      }
    ]
  }
}
Skrypt run-checks.sh, według szkicu z tej samej dokumentacji, uruchamia testy i przy porażce odsyła ich wynik do agenta kodem 2. Dokumentacja radzi, by hook trzymać dla reguł bez wyjątków i nie mnożyć ich: przy czterdziestu hookach większość to prawdopodobnie preferencje, które agent mógłby ocenić sam.
Hook pre-commit w Git działa na komputerze: niezerowy kod wyjścia przerywa commit przed jego utworzeniem. Dokumentacja Git zaznacza, że można go ominąć opcją –no-verify. Dlatego pre-commit to wygoda, a nie bramka. Prawdziwą bramką jest ta, której nie da się pominąć z poziomu komputera, czyli wymagany status na GitHubie. Pliki w katalogu .git/hooks nie trafiają do repozytorium (z mojej wiedzy, strona o githooks tego nie opisuje); do współdzielenia hooków służy ustawienie core.hooksPath wskazujące katalog śledzony w repozytorium.
Ma, bo zamienia aktualizacje zależności w małe pull requesty, które przechodzą przez te same bramki co reszta. Dependabot version updates to według dokumentacji GitHub automatyczne pull requesty utrzymujące zależności aktualne, także gdy nie ma żadnej znanej luki. Włączasz je plikiem dependabot.yml w repozytorium. Dependabot aktualizuje też odwołania do akcji w plikach workflow. Domyślnie nowe wydanie czeka trzy dni, zanim zostanie wzięte pod uwagę, a opcja cooldown zmienia ten czas; to opóźnienie nie dotyczy aktualizacji bezpieczeństwa, które są osobną funkcją. Opcja groups łączy aktualizacje w mniej pull requestów, bo domyślnie każda zależność dostaje własny. Dokumentacja zaznacza jeszcze, że gdy opiekunowie przestaną współpracować z pull requestami Dependabota, ten tymczasowo wstrzymuje aktualizacje. Każda nowa zależność trafia na listę, którą ktoś będzie aktualizował, więc zapytaj przy review, po co agent ją dodał i czy wystarczyłoby to, co już jest w projekcie. Dependabot nie zastąpi tej decyzji.
Minimalna konfiguracja dla npm, wprost z dokumentacji, z cotygodniowym harmonogramem:
version: 2
updates:
  - package-ecosystem: "npm"
    directory: "/"
    schedule:
      interval: "weekly"
Tu wraca wątek testów: pull request z aktualizacją zależności jest tak dobry, jak testy, które go sprawdzają. Przy słabym pokryciu zielony status Dependabota mówi niewiele. Dokumentacja GitHub każe przy takim pull requeście sprawdzić przejście testów oraz notatki o wydaniu, a dopiero potem scalić. Aktualizacje z lukami bezpieczeństwa i resztę tego tematu zostawiam artykułowi o bezpieczeństwie kodu z AI.
Pierwsza granica: testy sprawdzają tylko to, co ktoś opisał. Zielony pipeline nie powie, że funkcja robi coś innego niż chciał użytkownik. DORA zauważa, że szybkie generowanie kodu niesie ryzyko szybkiego pójścia w złym kierunku, gdy zespół nie ma jasnego obrazu potrzeb użytkowników. Druga: review człowieka męczy się przy dużych zmianach, a recenzent AI zawsze coś znajdzie. Trzecia: bramki kosztują czas i utrzymanie. Moim zdaniem test, który często pada bez powodu, uczy wszystkich klikać „merge mimo wszystko”, więc lepiej mieć mniej, ale stabilnych kontroli. Czwarta: w repozytorium jednoosobowym nie masz drugiej pary oczu, więc ciężar spada na testy i statusy. Piąta: DORA opisuje AI jako wzmacniacz, który powiększa mocne strony organizacji i jej słabości. Jeśli nie masz dziś testów ani CI, agent szybciej Cię w tym zostawi niż naprawi. I szósta: to nie jest temat bezpieczeństwa. Wycieki kluczy, luki w zależnościach i polityki dostępu mają osobny artykuł.
Portal klienta ma cztery warstwy kontroli: testy jednostkowe, komponentowe w jsdom, integracyjne na prawdziwym Postgresie oraz next build. Ostatnia nie jest formalnością. Sterownik Postgresa wciągnięty do paczki przeglądarki położył raz całą aplikację, a nie widział tego ani tsc, ani test komponentu, bo wszystkie funkcje działały poprawnie. Złapał to dopiero next build. 14 sierpnia minifikator zjadł zagnieżdżoną funkcję i pojawił się ReferenceError mimo zielonych testów. Wniosek z naszej dokumentacji: zielone testy nie dowodzą, że kod przetrwa build, dlatego build jest częścią komendy npm run verify.
W couchterm test dopisujemy do zmiany w tym samym commicie, a w forku Supercheck bramka jakości przed zakończeniem pracy obejmuje tsc, lint z --max-warnings 0 i testy, bez wyciszania błędów. Testy integracyjne portalu same się pomijają, gdy nie ma bazy, więc zielony wynik bez bazy niczego nie dowodzi. Według tej samej dokumentacji warstwa API jest pokryta w całości (32 z 32 tras), ale komponentów Reacta nietestowanych jest więcej niż testowanych: według naszej dokumentacji z 7 sierpnia 2026 zmiana w panelu admina jest sprawdzana tylko przez tsc i next build, czyli nikt nie sprawdza, czy panel się rysuje. Opinia: lista tego, czego testy nie pokrywają, jest warta więcej niż lista sukcesów, bo zielony wynik testów, które nie dotykają danej ścieżki, wygląda tak samo jak zielony wynik testów, które ją sprawdzają.
Nie. Test napisany razem z kodem często opisuje to, co kod robi, a nie to, co miał robić. Przeczytaj test przed implementacją i sprawdź, czy padłby przy błędnym kodzie. W DORA 2025 30 procent respondentów deklaruje mały lub zerowy poziom zaufania do kodu z AI, co moim zdaniem jest rozsądną postawą.
Nie znalazłem w źródłach pierwotnych progu liczby linii. DORA mówi o czasie: zmiana powinna zająć od kilku godzin do paru dni, a ponad tydzień to za dużo. Praktyczny test: czy przeczytasz diff w jednym posiedzeniu bez pomijania plików.
Nie. Dokumentacja Git mówi, że hook pre-commit można ominąć opcją –no-verify, a Actions z wymaganym statusem sprawdza zmianę po stronie GitHuba i blokuje merge. Pre-commit zostaw jako szybką informację zwrotną.
Prawdopodobnie workflow został pominięty przez filtr ścieżek, gałęzi lub wiadomość commita. Według dokumentacji GitHub takie pominięcie zostawia status w Pending i blokuje merge. Usuń filtry z workflow, którego status jest wymagany, albo nie wymagaj go.
Zależy od planu. Według dokumentacji ograniczenia gałęzi działają w repozytoriach publicznych na planie Free oraz w prywatnych na planach Pro, Team i Enterprise. Dokładne warunki dla swojego konta sprawdź w ustawieniach repozytorium.
To moja opinia: tak dla drobnych aktualizacji, jeśli testy są rzetelne, i nie dla zmian, które wymagają decyzji. Auto-merge GitHub scala pull request dopiero po spełnieniu wymaganych przeglądów i statusów, więc działa tylko tak dobrze jak one.
Nie w całości. Dokumentacja Claude Code opisuje recenzenta w świeżym subagencie jako sposób na recenzję bez wpływu rozumowania autora, ale też ostrzega, że szuka on zawsze czegoś do poprawienia. Traktuj go jako pierwsze sito, decyzja zostaje u człowieka.
Stan na 11 listopada 2026. Dokumentacje GitHub, Claude Code i Codex zmieniają się często, więc nazwy opcji i limity sprawdź w aktualnej wersji przed wdrożeniem.
Zostań w pętli
Nowe artykuły, narzędzia i case study prosto na maila. Bez spamu, bez sprzedaży.