AI i Automatyzacje
Do aplikacji pisanej z agentem AI wybierz stack, który da się przeczytać, przetestować i przenieść gdzie indziej: HTML z serwera i htmx albo React z Next.js, zależnie od najcięższego ekranu, do tego Postgres, monolit modularny w jednym repozytorium, krótki AGENTS.md, bramki w CI i hosting zarządzany. To moja rekomendacja, nie wynik badania.
Łukasz Ślusarski, important.is. Stan na 11 listopada 2026. Opracowane na podstawie siedmiu artykułów tej serii oraz dokumentacji Lovable, Bolt i Replit (GitHub, eksport kodu).
Pytanie „jaki stack” w świecie agentów zmienia sens. Agent napisze aplikację w prawie każdej technologii, więc o wyborze decyduje co innego: kto ten kod przeczyta w pull requeście, kto go zaktualizuje za pół roku i jak łatwo go przenieść, gdy zmieni się cennik albo zespół. Ten tekst jest dla osób i firm, które budują z Claude Code, Codex, Cursorem albo w narzędziach typu Lovable, Bolt i Replit (czyli robią vibe coding), trzymają kod na GitHubie i chcą go rozwijać.
To przewodnik zbiorczy, bez pełnych omówień. Każdą decyzję opisuje osobny artykuł serii, a tutaj masz tabelę, kryteria, jedną liczbę z każdego tekstu i link. Nie porównuję modeli ani narzędzi do kodowania, o tym pisaliśmy w osobnych wpisach (linki na dole). Piszemy to z doświadczenia czterech własnych aplikacji, które mają cztery różne stacki, więc w jednej z sekcji wyjaśniamy, dlaczego nie stosujemy własnej tabeli wszędzie.
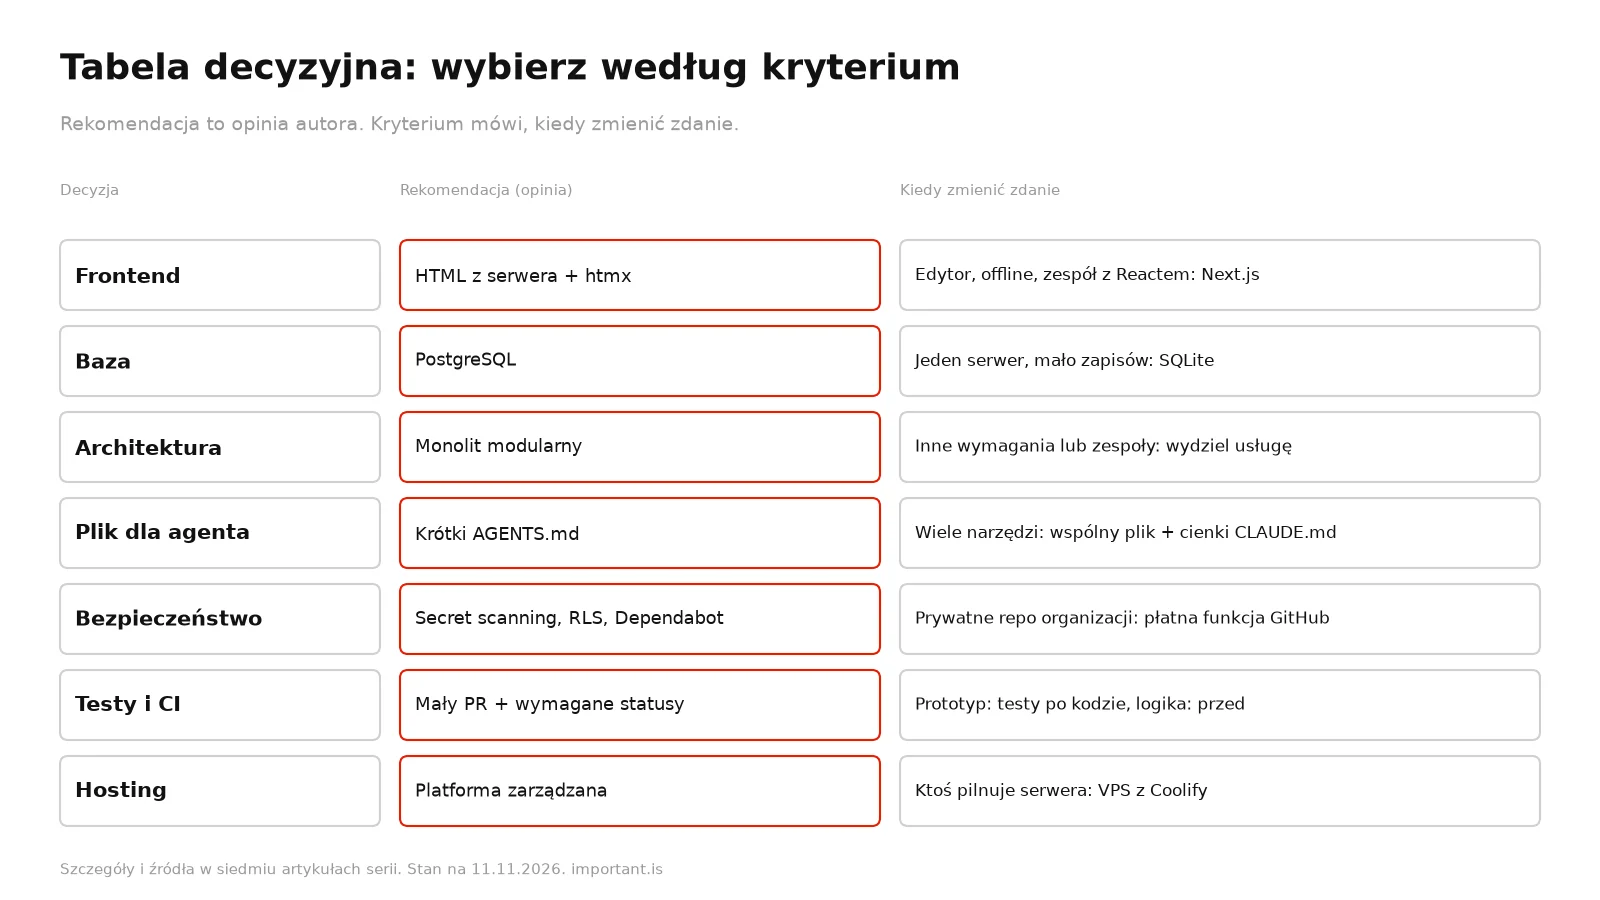
Kolumna „Rekomendacja” to moja opinia oparta na źródłach z poszczególnych artykułów. Kolumna „Kryterium” mówi, kiedy zmienić zdanie.
| Decyzja | Rekomendacja (opinia) | Kryterium zmiany | Artykuł |
|---|---|---|---|
| Frontend | HTML z serwera i htmx, a ciężki ekran jako wyspa Reacta | Edytor, arkusz, przeciąganie, praca offline albo zespół znający React z gotowymi komponentami: React z Next.js | React czy HTMX |
| Baza i backend | PostgreSQL: własny, zarządzany albo w pakiecie z Supabase | Jeden serwer i mało równoczesnych zapisów: SQLite. Dane w dokumentach i aplikacja mobilna: Firestore | Backend i baza |
| Język backendu | Ten sam co frontend, najczęściej TypeScript | Aplikacja kręci się wokół danych i modeli: Python | Backend i baza |
| Architektura | Monolit modularny, jedno repozytorium, granice sprawdzane w CI | Fragment z innymi wymaganiami albo niezależne zespoły: wydziel usługę | Monolit czy mikroserwisy |
| Plik dla agenta | Krótki AGENTS.md w gicie: komendy, niestandardowe zasady, granice | Wiele narzędzi: AGENTS.md jako wspólny plik i cienki CLAUDE.md | AGENTS.md i CLAUDE.md |
| Bezpieczeństwo | Secret scanning, push protection, Dependabot, RLS sprawdzone na dwóch kontach | Prywatne repozytoria organizacji wymagają płatnej funkcji GitHub Secret Protection | Bezpieczeństwo kodu z AI |
| Testy i CI | Mały pull request, wymagane statusy w Actions, ochrona gałęzi | Prototyp: testy po kodzie. Błąd i logika: testy przed kodem | Testy, review i CI |
| Hosting | Platforma zarządzana, dopóki nikt nie pilnuje serwera | Stabilna aplikacja i ktoś z czasem na administrację: VPS z Coolify | Hosting i wdrażanie |
Ta sama tabela w formie grafiki, do przypięcia przy monitorze.
Zrobić to razem?
Wdrażam takie rzeczy w firmach na co dzień. Umów 30 minut, pogadamy konkretnie o Twoim przypadku. Bez prezentacji sprzedażowej.
Umów bezpłatną rozmowę →
Da się, jeśli zaczniesz od pięciu pytań zamiast od nazw technologii. Kto utrzyma ten kod za pół roku? Jaki jest najcięższy ekran w aplikacji? Czy dane tworzą relacje, jak klient, zamówienia i płatności? Ilu piszących (ludzi i agentów) dotyka tych samych plików? Kto odbierze alarm, gdy serwer padnie? Odpowiedzi prowadzą do wyborów z tabeli wyżej. Badań jest mało: w jedynym znalezionym benchmarku kosztu agenta (Nolan Lawson, 28 października 2026, 12 stacków, po 5 przebiegów) mediany kosztu mieściły się między 2,67 USD (Hono z htmx) a 4,97 USD (Angular), a Angular w 2 z 5 przebiegów nie dał działającej aplikacji. Aplikacja była jedna i prosta, więc to nie wyrok. Nie znalazłem niezależnego pomiaru, że agent pisze lepszy kod dla popularniejszego stacku. Popularność pomaga w czym innym: łatwiej o ludzi, biblioteki i odpowiedzi. Jeśli ktoś w zespole zna dany stack, ma pierwszeństwo przed nowinką, bo to on przeczyta diff.
Siedem warstw układa się jedna na drugiej: na dole hosting, wyżej baza i backend, frontend i architektura kodu, a ponad nimi repozytorium z instrukcjami dla agenta, bramki jakości i bezpieczeństwo, które przecinają wszystkie poziomy. Schemat pokazuje każdą warstwę z rekomendacją i liczbą z odpowiedniego artykułu. Zwróć uwagę, że trzy górne warstwy nie są technologią, tylko procesem. Moim zdaniem to one decydują, czy aplikacja z agenta da się utrzymać, bo żaden wybór frameworka nie naprawi braku testów ani przeglądu zmian. Dlatego przewodnik zaczyna od narzędzi, a kończy na zwyczajach: krótki plik instrukcji, mały pull request, wymagane statusy i sprawdzone uprawnienia do danych. Każda z tych rzeczy kosztuje godziny, nie tygodnie, i można ją dodać do istniejącego projektu, także takiego, który powstał w całości z promptów. Liczby w schemacie pochodzą z artykułów serii: 20 USD za miejsce programisty w Vercel Pro, 55,6% dla Postgresa, 38% testów z luką u Veracode i 200 linii jako górna granica pliku instrukcji w Claude Code.
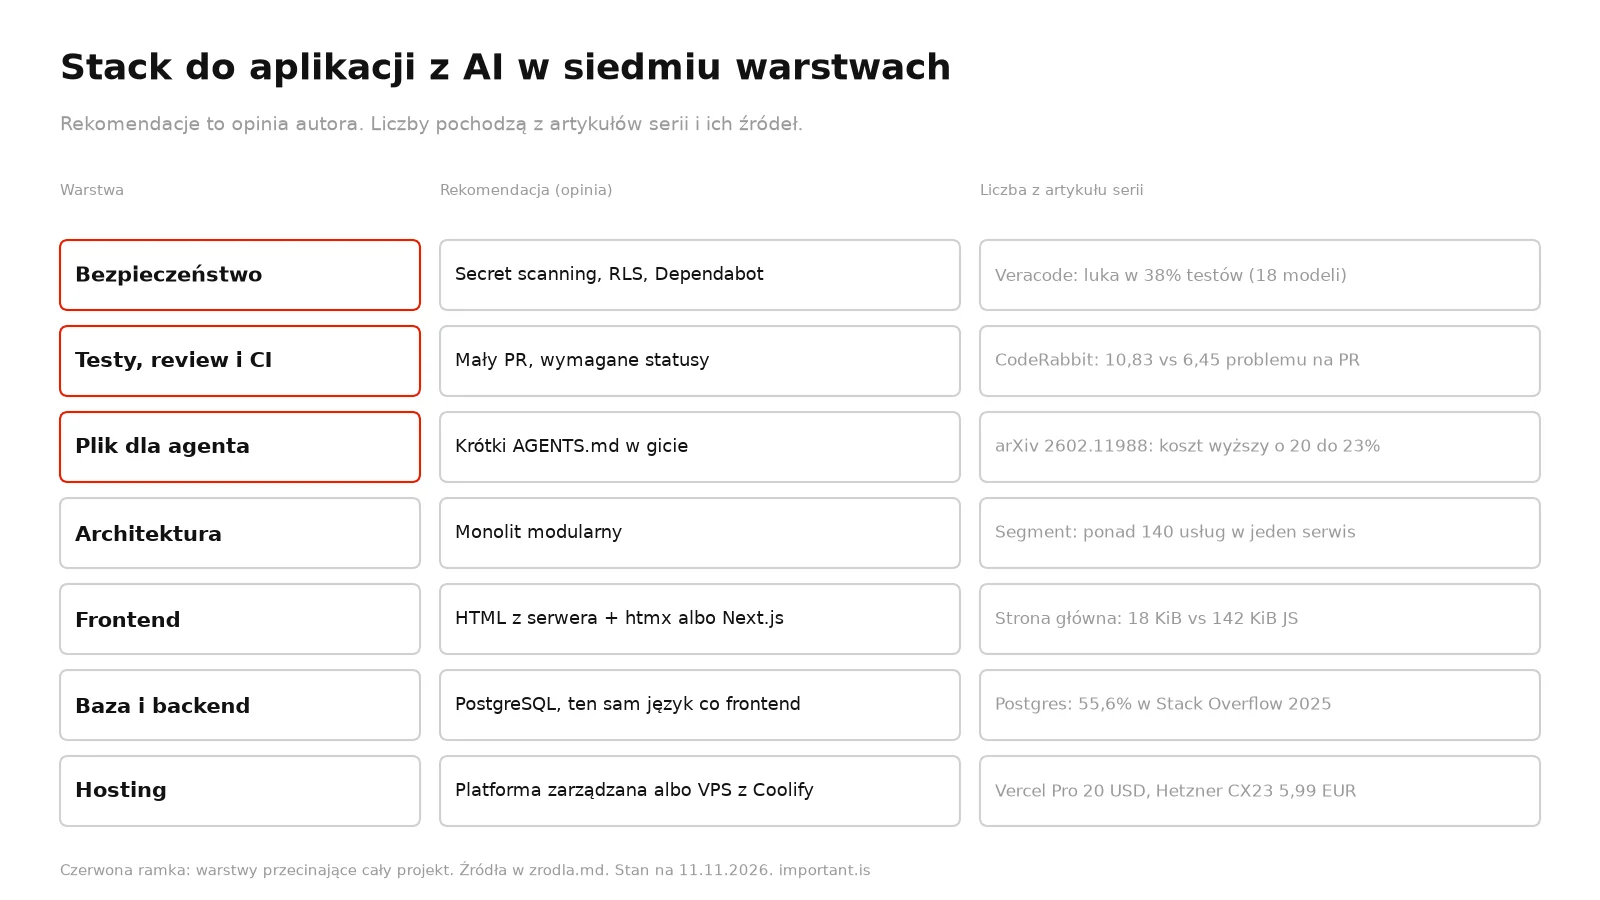
Poniżej jedno streszczenie na artykuł, z jedną liczbą przejętą z tego tekstu. Szczegóły, źródła i zastrzeżenia są w oryginałach.
Do paneli, formularzy i stron publicznych wystarczy HTML z serwera i htmx, a React z Next.js ma sens przy ekranach ciężkich interaktywnie. W benchmarku Lawsona mediana kosztu zbudowania tej samej aplikacji wyniosła 2,67 USD dla Hono z htmx i 3,14 USD dla Next.js, a strona główna ważyła 18 KiB JavaScriptu wobec 142 KiB. Pełne omówienie: React czy HTMX.
Do większości aplikacji z użytkownikami wystarczy PostgreSQL, a SQLite starcza przy jednym serwerze i małej liczbie zapisów. Postgres jest najczęściej używaną bazą w ankiecie Stack Overflow 2025: 55,6% wszystkich respondentów. Tam też porównanie Supabase, Neon, Firebase i Cloudflare D1: Backend i baza.
Dla małego zespołu najlepszym punktem startu jest monolit modularny z granicami sprawdzanymi w CI. Segment zamienił ponad 140 usług w jeden serwis, bo samo utrzymanie pochłaniało trzech inżynierów na pełen etat. To relacja jednego zespołu, nie dowód ogólny. Całość: Monolit czy mikroserwisy.
Agent nie gwarantuje bezpiecznego kodu. Komunikat Veracode z 29 października 2026 podał, że 38% testów kodu z 18 modeli kończyło się luką. Artykuł opisuje też sekrety w repozytorium, wymyślone pakiety, RLS i dwie głośne luki we frameworkach: Bezpieczeństwo kodu z AI.
Zmiana agenta ma przejść tę samą drogę co każda inna: mały pull request, automatyczne testy, przeczytany diff i merge dopiero po zielonych wymaganych statusach. Raport DORA 2025 pokazuje, że AI poprawia przepustowość, ale zwiększa niestabilność, a CodeRabbit naliczył 10,83 problemu na pull request ze współautorem AI wobec 6,45 przy pracy samego człowieka (źródło dostawcy narzędzia do review). Szczegóły: Testy, review i CI.
Aplikację Node lub Next.js hostuj na platformie zarządzanej, dopóki nie masz osoby pilnującej serwera. Vercel Pro kosztuje 20 USD miesięcznie za miejsce programisty, a instancja CX23 u Hetznera 5,99 EUR bez VAT, ale kopie, aktualizacje i alarmy spadają wtedy na ciebie. Ceny pochodzą z cenników z 11 listopada 2026, porównanie siedmiu opcji jest tutaj: Hosting i wdrażanie.
Plik instrukcji w repozytorium ma być krótki, pisany ręcznie i trzymany w gicie. Badanie arXiv 2602.11988 pokazało, że pliki generowane przez LLM obniżyły odsetek rozwiązanych zadań o 0,5 do 2 punktów, a koszt wzrósł o 20 do 23 procent. Claude Code zaleca poniżej 200 linii na plik. Jak go napisać: AGENTS.md i CLAUDE.md.
Poniższe zestawy to moje opinie, złożone z rekomendacji z artykułów serii, a nie przetestowane wzorce. Liczy się to, że wybory z tabeli nie są niezależne: frontend ciągnie za sobą język backendu, a hosting wynika z tego, kto ma pilnować serwera.
Panel dla klienta albo narzędzie wewnętrzne: HTML z serwera i htmx, PostgreSQL, monolit w jednym języku, hosting zarządzany. To najmniej ruchomych części i najkrótszy diff do przeczytania, więc najlepiej pasuje do jednej osoby z agentem. Aplikacja z edytorem, arkuszem albo pracą offline: React z Next.js dla ciężkiego ekranu, ta sama baza, te same bramki w CI, a granice między modułami sprawdzane automatycznie, bo większy frontend szybciej rozlewa logikę po plikach. Produkt rosnący z prototypu z Lovable lub Bolt: repozytorium z GitHuba, AGENTS.md, RLS sprawdzone na dwóch kontach i testy przed każdą większą zmianą, a decyzję o hostingu odkładasz do chwili, gdy kod uruchomisz poza platformą.
Podłącz GitHub od pierwszego dnia i traktuj repozytorium jako miejsce, w którym aplikacja naprawdę mieszka. Wszystkie trzy platformy mają integrację z GitHubem, ale różnią się szczegółami, które zmieniają plan wyjścia. Lovable synchronizuje zmiany w obie strony, pracuje na jednej gałęzi naraz, a synchronizacja zawsze tworzy nowe repozytorium (również po ponownym połączeniu). Skasowanie repozytorium zatrzymuje synchronizację. Dokumentacja pozwala sklonować repozytorium i pracować w swoim IDE. Bolt tworzy commity automatycznie, co 30 sekund sprawdza zmiany wprowadzone poza Bolt, a projekt zostaje na gałęzi main. Replit opisuje GitHub jako miejsce kopii zapasowej i współpracy, z wypychaniem i importem projektu w obie strony. Replit w dokumentacji importu wymienia osobno, czego nie przenosi: wartości sekretów i zmiennych środowiskowych. Nie znalazłem w dokumentacji Replit osobnej strony o eksporcie kodu, więc plan wyjścia opiera się tu na GitHubie. We wszystkich trzech przypadkach pierwszym testem jest to samo: czy po sklonowaniu aplikacja uruchamia się bez platformy.
Poniższa tabela zbiera te różnice. Dane pochodzą z dokumentacji producentów pobranej 11 listopada 2026.
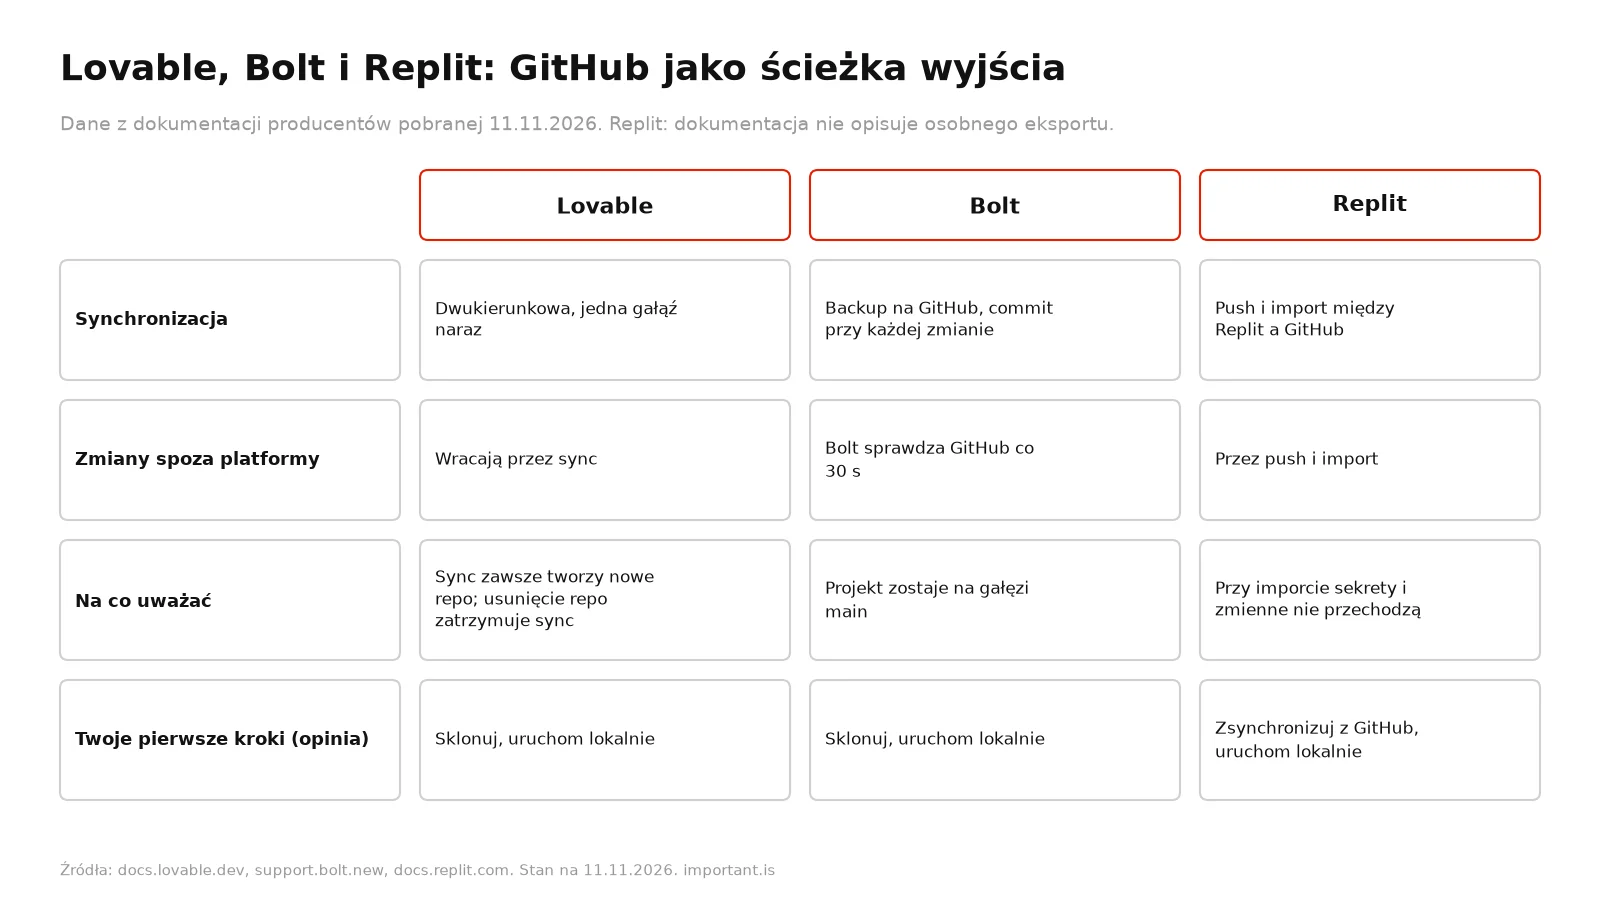
Moja kolejność działań przy aplikacji, która wyrosła z takiego narzędzia, to opinia, nie przepis producenta. Po pierwsze, sklonuj repozytorium i uruchom aplikację lokalnie, żeby sprawdzić, że działa bez platformy. Po drugie, spisz w AGENTS.md komendy uruchomienia i testów. Po trzecie, jeśli backendem jest Supabase (Lovable opisuje go w dokumentacji jako bazę, logowanie, pliki i funkcje serwerowe), sprawdź polityki RLS na dwóch kontach. Wpis CVE-2025-48757 dotyczył właśnie niewystarczających polityk RLS w stronach generowanych przez Lovable, choć dostawca go kwestionuje i wskazuje, że za dane odpowiada klient. Po czwarte, dodaj testy i wymagane statusy w CI, zanim zaczniesz poważne zmiany. Po piąte, dopiero potem decyduj o hostingu. Sekrety i zmienne środowiskowe przenieś ręcznie: Replit pisze wprost, że przy imporcie z GitHuba wartości sekretów i zmiennych nie przechodzą.
Kolejność ma znaczenie, bo wcześniejsze kroki tanio zabezpieczają późniejsze. To moja rekomendacja, a nie wynik badania.
Żaden wybór technologii nie zastąpi człowieka, który czyta diff. Stack nie naprawi złego modelu danych, braku testów ani niejasnych wymagań. Raport DORA opisuje AI jako wzmacniacz: powiększa mocne strony organizacji i jej słabości, więc jeśli nie masz dziś testów i CI, agent szybciej cię w tym zostawi niż naprawi. Tabela decyzyjna to też uogólnienie. Opiera się na jednym benchmarku kosztu agenta (jedna prosta aplikacja, jeden model), na ankietach opisujących respondentów, nie cały rynek, i na cennikach, które zmieniają się bez zapowiedzi. Nie znalazłem porównania agentów na złożonych ekranach ani niezależnych danych o utrzymaniu kodu z AI w czasie. Nie zastępuje też oceny prawnej, umów z dostawcami i kosztów, których nie liczyłem: VAT, kursów walut, domen i poczty. Dla WordPressa i treści ten przewodnik się nie nadaje, tam obowiązują inne zasady (link do wpisu o headless CMS niżej).
Poniższa tabela pokazuje, jak wyglądają cztery aplikacje, które rozwijamy z agentami (jedna to fork), stan na 11 listopada 2026.
| Aplikacja | Frontend | Backend i baza | Uruchomienie |
|---|---|---|---|
| Portal klienta | Next.js 16, React 19, Tailwind 4 | Next.js, Drizzle, Postgres | Coolify |
| Sherpa (poczta w przeglądarce) | czysty JavaScript, PWA; w planie React 19 i Vite | Python (jeden plik server.py), CLI himalaya | LaunchAgent na macOS |
| couchterm (terminal tmux) | przeglądarka z xterm.js, aplikacja Electron | Node.js, node-pty, tmux | launchd |
| Supercheck (fork open source) | Next.js 16, React 19 | Express 5, Drizzle, Postgres, Redis | Docker Compose, testy jako Kubernetes Jobs |
Nie mamy jednego stacku. Mamy kilka, bo aplikacje robią różne rzeczy: portal obsługuje klientów, Sherpa czyta pocztę, couchterm trzyma terminale. Wspólne są nawyki, o których piszemy w tej serii: plik instrukcji dla agenta, test razem ze zmianą, build w weryfikacji, kopie zapasowe, których działanie sprawdzamy (rozmiar i status przebiegów, bez pełnego odtworzenia). To obserwacja z naszych projektów, nie reguła dla wszystkich.
Bo tabela na początku to opinia o dobrym punkcie startu dla nowej aplikacji, a nasze powstawały w różnym czasie i do różnych zadań. Portal klienta jest w Next.js i działa na własnym serwerze z Coolify, a nie jako htmx na platformie zarządzanej. Zapłaciliśmy za to konkretnie: w sierpniu 2026 webhook nie uruchamiał wdrożeń, a migracja bez IF EXISTS wpędziła kontener w pętlę restartów na jedenaście minut (szczegóły w artykule o hostingu). Sherpa jest czystym JavaScriptem, a 11 listopada 2026 zdecydowaliśmy się przepisać jej front na React, bo chcemy gotowej biblioteki komponentów dopasowanej do naszych potrzeb. Sherpa ma pracę offline i gęsty interfejs poczty, więc pasuje do kryterium zmiany z pierwszego wiersza tabeli, choć powodem zapisanym w planie jest właśnie biblioteka komponentów. Wniosek jest praktyczny: tabelę traktuj jako domyślny wybór i zmieniaj ją świadomie, z zapisanym powodem, a nie dlatego, że poprzedni projekt wyglądał inaczej.
Taki, który zespół potrafi przeczytać i utrzymać. Moja rekomendacja na start: Postgres, monolit modularny w jednym repozytorium, frontend dobrany do najcięższego ekranu i bramki w CI. Konkretne wybory i kryteria zmiany są w tabeli na początku.
Nie. Do formularzy i paneli wystarcza HTML z serwera, a Next.js ma sens przy ciężkich ekranach. Dane i kryteria: React czy HTMX.
Nie znalazłem niezależnego pomiaru, który by to rozstrzygał. Popularność pomaga w czym innym: łatwiej znaleźć ludzi i biblioteki. Każde twierdzenie „agenci lepiej znają X” traktuj jako opinię.
Może się nadawać, jeśli przechodzi te same bramki co każdy kod: testy, przegląd diffu, skanowanie sekretów i zależności, sprawdzone uprawnienia do danych. Skalę luk w kodzie z agentów opisuje artykuł o bezpieczeństwie, więc kod z agenta sprawdzaj zawsze.
Połącz ją z GitHubem, sklonuj repozytorium i uruchom lokalnie, dodaj AGENTS.md, testy i CI, a dopiero potem zmieniaj hosting. Szczegóły integracji różnią się między platformami, więc sprawdź dokumentację swojej.
Nie musi być osobna. Dokumentacja Supabase wymienia rozszerzenie pgvector do przechowywania wektorów w zwykłym Postgresie. Progu, od którego osobna baza się opłaca, nie sprawdzałem.
Dla małego zespołu zwykle nie. Przykłady i granice: Monolit czy mikroserwisy.
To zależy od tego, kto pilnuje serwera. Ceny i koszt utrzymania: Hosting i wdrażanie.
Może zaproponować, ale decyzję zostaw człowiekowi. Agent nie ponosi kosztu utrzymania, nie zna twoich ludzi ani budżetu i chętnie dobiera to, co akurat zna z danych treningowych. Daj mu gotowy wybór i zapisz go w AGENTS.md: język, framework, bazę, komendy testów i zakazy. Wtedy kolejne zadania nie zmieniają stacku przy okazji, a diff dotyczy tylko zmiany, o którą prosiłeś. Badanie arXiv 2602.11988 uzasadnia, żeby tego pliku nie generować automatycznie, tylko pisać go ręcznie.
Nie mierzyłem tego i nie znalazłem rzetelnych danych. To moja ocena, nie pomiar: AGENTS.md, Dependabot, ochrona gałęzi i secret scanning to pojedyncze pliki albo przełączniki w ustawieniach GitHuba.
Vibe coding to budowanie aplikacji przez opisywanie jej agentowi i akceptowanie wyniku bez czytania kodu linia po linii. Na produkcję taka aplikacja może trafić dopiero po tych samych bramkach co każdy kod: repozytorium na GitHubie, testy, przegląd zmian i sprawdzone uprawnienia do danych. Kolejność działań po prototypie z Lovable, Bolt albo Replit jest w sekcji wyżej.
Zacznij od AGENTS.md, bo plik instrukcji ustawia pracę agenta w każdej innej warstwie. Potem frontend i baza, architektura, bezpieczeństwo oraz testy z CI, a na końcu hosting, bo o nim najłatwiej zdecydować, gdy wiesz już, co uruchamiasz. To moja kolejność, nie obowiązkowa.
Stan na 11 listopada 2026. Liczby pochodzą z siedmiu artykułów serii i ich źródeł, rekomendacje to moje opinie, a dokumentacje platform i cenniki zmieniają się, więc przed decyzją sprawdź je u producenta.
Zostań w pętli
Nowe artykuły, narzędzia i case study prosto na maila. Bez spamu, bez sprzedaży.