AI i Automatyzacje
Dla małego zespołu, który buduje aplikację z agentami AI, najlepszym punktem startu jest monolit modularny: jedno repozytorium, jedno wdrożenie, moduły z jawnymi granicami i opisanymi kontraktami. Mikroserwisy mają sens dopiero wtedy, gdy konkretny fragment ma inne wymagania albo niezależne zespoły muszą wydawać osobno. Moim zdaniem agent AI tej zasady nie zmienia, tylko ją wzmacnia: im wyraźniejsze granice, tym mniej szkód zrobi jedna zła zmiana.
Łukasz Ślusarski, important.is. Stan na 11 listopada 2026. Opracowane na podstawie wpisów inżynierskich Shopify, Segment i Prime Video, artykułów Martina Fowlera, raportu DORA oraz dokumentacji Claude Code i standardu AGENTS.md.
Agent potrafi w krótkim czasie dopisać funkcję, która dotyka kilku plików w różnych miejscach. Pytanie o architekturę przestaje być akademickie, bo od układu kodu zależy, ile agent musi przeczytać, co może zepsuć i co sprawdzi za niego test. Ten tekst jest dla osób, które budują aplikację z Claude Code, Codex, Cursorem czy podobnym narzędziem, trzymają ją na GitHubie i chcą ją potem rozwijać. U nas portal klienta to jedna aplikacja Next.js z jedną bazą, a granice trzymamy w plikach i zapisanych decyzjach (opis na końcu).
Nie znalazłem badania, które porównywałoby agentów pracujących w monolicie i w mikroserwisach nad tym samym produktem. Dlatego opieram się na wpisach zespołów, dokumentacji narzędzi i własnej ocenie, a opinie oznaczam jako opinie. Nie wybieram tu technologii, to temat artykułu o backendzie i bazie. Całość układa się w serię opisaną w artykule o stacku do aplikacji z AI.
| Pytanie | Odpowiedź | Podstawa |
|---|---|---|
| Od czego zacząć? | Monolit w jednym repozytorium | Martin Fowler, MonolithFirst, 2015 |
| Jak go porządkować? | Moduły z publicznym wejściem, importy sprawdzane w CI | Shopify Engineering, 2020 |
| Kiedy wydzielić usługę? | Gdy fragment ma inne wymagania niż reszta | Shopify (renderowanie sklepu i przechowywanie kart) |
| Co daje agentowi granice? | Krótszy kontekst i sprawdzenie, które da się uruchomić | Dokumentacja Claude Code, Anthropic |
| Jak zmieniać bazę? | Kilka osobnych kroków zamiast jednego skoku | Stripe Engineering, 2017 |
Zrobić to razem?
Wdrażam takie rzeczy w firmach na co dzień. Umów 30 minut, pogadamy konkretnie o Twoim przypadku. Bez prezentacji sprzedażowej.
Umów bezpłatną rozmowę →
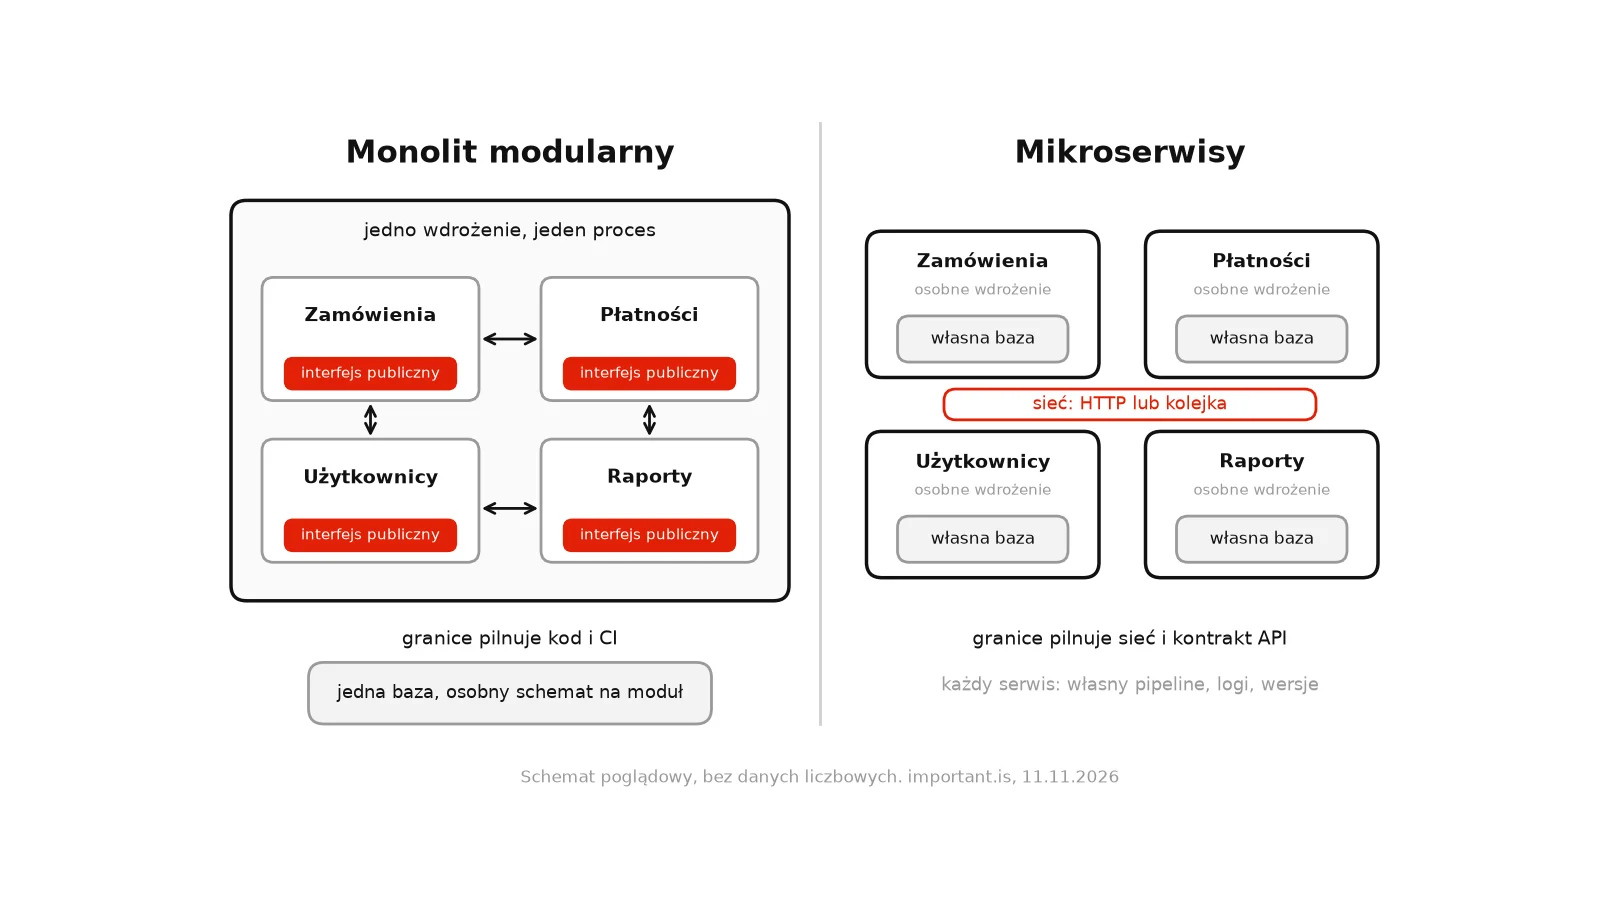
Monolit modularny to jedna aplikacja wdrażana jako całość, podzielona na moduły, które rozmawiają ze sobą tylko przez wyznaczone wejścia. Mikroserwisy to wiele osobno wdrażanych programów, które rozmawiają przez sieć. W Shopify główny monolit miał według wpisu z 16 września 2020 roku ponad 2,8 mln linii kodu w Rubym i setki programistów, a podzielono go na 37 komponentów. Cel zespołu brzmi: programista ma czuć, że pracuje nad dużo mniejszą aplikacją, niż ma w rzeczywistości. W takim układzie zmiana na styku dwóch modułów to jeden commit i jedno wdrożenie. W mikroserwisach ta sama zmiana to dwa wdrożenia, zgodność wersji i obsługa sytuacji, w której druga strona nie odpowiada. Fowler nazywa ten koszt „premią” za mikroserwisy i wylicza jej składniki: automatyczne wdrażanie, monitoring, obsługa awarii i spójność ostateczna. Różnica nie leży więc w liczbie linii kodu, tylko w tym, gdzie biegnie granica: w kodzie czy w sieci.
Schemat poniżej zestawia oba układy. Czerwony pasek oznacza publiczne wejście modułu, czyli jedyne miejsce, przez które wolno do niego sięgać.
Jest też wariant pośredni, który ma własną nazwę. Mówi się o rozproszonym monolicie, gdy usługi formalnie są osobne, ale trzeba je wdrażać razem. To moja definicja robocza, nie termin z jednego źródła. Raport DORA stwierdza podobnie, że wiele architektur usługowych i mikroserwisowych nie daje w praktyce niezależności zespołów, dla której je wybrano.
Dwa głośne wpisy inżynierskie opisują powrót od wielu usług do jednej: Prime Video w 2023 roku i Segment w 2018. Zespół Prime Video zbudował narzędzie do analizy jakości strumieni z usług bezserwerowych: AWS Step Functions orkiestrowały funkcje Lambda, a pośrednie dane lądowały w S3. Według relacji InfoQ taki układ obsługiwał około 5 procent oczekiwanego obciążenia i był drogi. Po zebraniu komponentów w jednym procesie zespół zgłosił redukcję kosztów o 90 procent. Autor wpisu, Marcin Kolny, ocenił, że rozproszone podejście nie przynosiło w tym konkretnym przypadku wielu korzyści. Segment miał ponad 140 usług, po jednej na każdy cel integracji, a trzech inżynierów na pełen etat zajmowało się głównie utrzymaniem. Jeden zepsuty test wywracał testy wszystkich usług, a zmiana, która powinna zająć godzinę lub dwie, potrafiła zająć od kilku dni do tygodnia. Segment zamienił ponad 140 usług w jeden serwis.
Zwróć uwagę na dwa zastrzeżenia. Prime Video to jedno narzędzie, a nie cała platforma, i autor wpisu pisał o „naszym konkretnym przypadku”, nie o regule. Segment sam przyznaje koszty powrotu: trudniejszą izolację awarii i słabsze pamięci podręczne. Oba wpisy to relacje zespołów o własnych systemach. Pierwotnego tekstu Prime Video nie udało mi się otworzyć, więc opieram się na InfoQ i oznaczam to w źródłach jako wtórne.
Segment podaje jedną liczbę, którą da się zestawić: poprawek we wspólnych bibliotekach było 32 w czasie mikroserwisów i 46 rok po przejściu na jeden serwis. Zespół przytacza to jako oznakę, że wspólny kod stał się łatwiejszy do rozwijania. To jego interpretacja, a okres, którego dotyczy liczba 32, nie jest we wpisie wskazany precyzyjnie, więc nie traktuj tego porównania jako pomiaru.
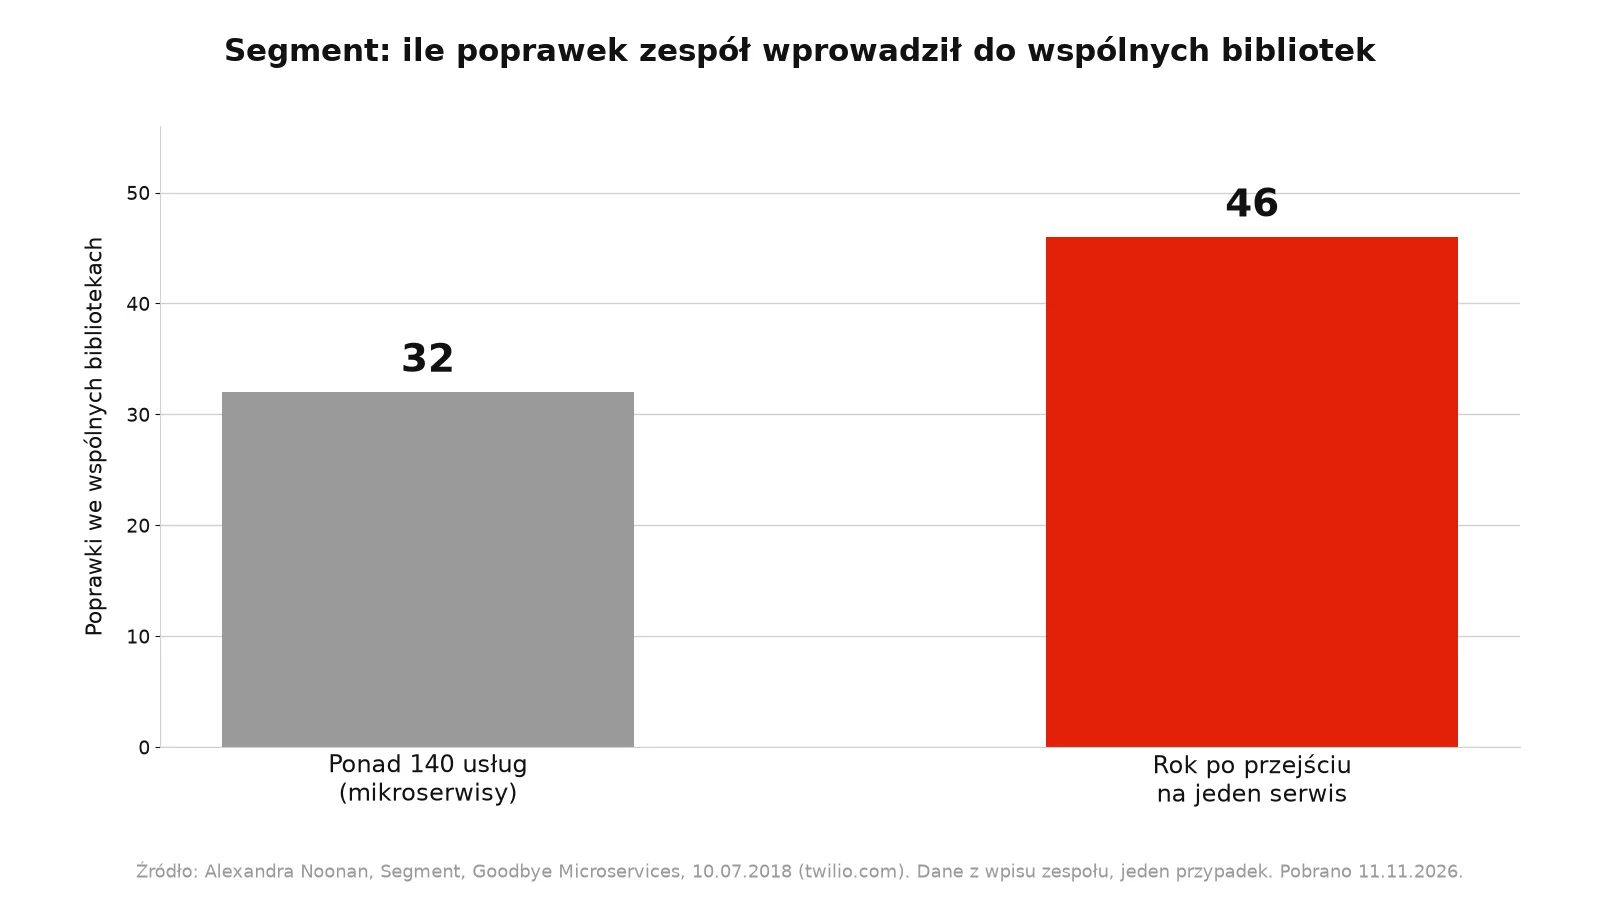
To jeden przypadek z jednej firmy i nie jest to dowód ogólny. Pokazuje jednak mechanizm, który moim zdaniem dotyczy też pracy z agentem: im więcej osobnych miejsc trzeba zsynchronizować, tym rzadziej ktoś odważy się ruszyć wspólny kod.
Według Martina Fowlera większość systemów powinna powstać jako jedna aplikacja, a o mikroserwisach wolno myśleć dopiero wtedy, gdy system jest zbyt złożony, żeby zarządzać nim jako monolitem. W tekście MonolithFirst z 3 czerwca 2015 pisze też, że niemal wszystkie udane historie o mikroserwisach zaczęły się od monolitu, który urósł i został rozbity. Dodaje, że nawet doświadczeni architekci w znanej dziedzinie mają duży kłopot z trafnym poprowadzeniem granic na starcie, a przenoszenie funkcji między usługami jest dużo trudniejsze niż w monolicie. W drugim tekście, MicroservicePremium z 13 maja 2015, Fowler zauważa, że liczba osób nie rozstrzyga sama: widział zespół sześćdziesięciu osób z 20 usługami i zespół czterech osób z 200 usługami. Zastrzeżenie: oba teksty mają ponad jedenaście lat i są opiniami uznanego praktyka, nie pomiarem. Zgadzają się jednak z późniejszymi relacjami Segment i Prime Video.
Raport DORA przypomina, po co w ogóle dzieli się systemy: żeby zespół mógł zmieniać, testować i wdrażać swoją część bez czekania na innych. Warunkiem są dobrze zdefiniowane interfejsy i wyraźne konteksty, a nie sama sieć. Moim zdaniem zespół od jednej do kilku osób nie ma problemu organizacyjnego, który mikroserwisy rozwiązują. Ma za to wszystkie ich koszty: wiele pipeline’ów, wersji, logów i miejsc, w których coś może się rozjechać.
Nie znalazłem badania, które by to rozstrzygało, ale dostępne dane wskazują ten sam kierunek: agent działa lepiej, gdy kontekst jest mały, granice jawne, a wynik da się sprawdzić jednym poleceniem. Anthropic opisuje kontekst jako zasób ograniczony, z malejącymi korzyściami, i zaleca dawanie agentowi najmniejszego możliwego zestawu potrzebnych informacji oraz lekkich identyfikatorów, takich jak ścieżki plików, które agent dociąga w razie potrzeby. Dokumentacja Claude Code mówi, że dla agenta najcenniejsze jest sprawdzenie, które zwraca wynik zdał albo nie zdał: test, build, linter. W monolicie jedno uruchomienie testów obejmuje zmianę na styku modułów. Przy kilku usługach to kilka repozytoriów albo kilka zestawów testów i kontrakt, który trzeba utrzymać w zgodności po obu stronach. Anthropic opisuje też zjawisko „context rot”: wraz ze wzrostem okna kontekstu spada trafność przypominania informacji, więc dokładanie kolejnych repozytoriów do kontekstu nie jest darmowe.
Dwie prace naukowe z 2026 roku dotykają tematu pośrednio. BeyondSWE (arXiv 2603.03194) bada zadania wykraczające poza jedno repozytorium, na 500 przypadkach z 246 repozytoriów. Najlepszy agent oparty na OpenHands osiągnął 46,12 punktu średnio, a najmocniejszy zestaw Codex z GPT-5.4 wynik 56,65 przy poleceniu uwzględniającym wyszukiwanie. To nie jest test mikroserwisów jednego produktu i abstrakt nie podaje wyniku dla jednego repozytorium, więc nie wyciągam z tego porównania. Druga praca (arXiv 2603.09004) oceniła 144 wygenerowane mikroserwisy i wskazała, że w czystym starcie testy integracyjne przechodziły w 81 do 98 procent przypadków, ale w pracy przyrostowej testy jednostkowe w 50 do 76 procent. Autorzy uznali, że w pełni autonomiczne generowanie mikroserwisów nie jest jeszcze osiągalne. Wniosek jest ostrożny: kontrakt pomaga, a człowiek nadal musi patrzeć.
Granicę trzeba zapisać w kodzie i sprawdzać maszynowo, bo wpis w AGENTS.md jest prośbą, a nie zabezpieczeniem. Dokumentacja Claude Code mówi wprost, że plik z instrukcjami agent traktuje jako kontekst, a nie wymuszoną konfigurację, i że regułę bez wyjątków trzeba przenieść do mechanizmu, który ją wymusza, na przykład hooka albo CI. Jako przykłady reguł dokumentacja podaje „nigdy nie czytaj .env” i „nie ruszaj katalogu migracji”. Shopify poszło tą drogą: narzędzie Packwerk analizuje statyczne odwołania do stałych i zgłasza przekroczenia granic pakietów, a w największym kodzie działa w kilka minut i blokuje pull requesty. To narzędzie dla Rubiego. Dla innych języków trzeba szukać odpowiednika, a ja nie sprawdzałem, jakie istnieją. Reguła w pliku instrukcji działa jak prośba, a reguła w CI jak zamek: agent dostaje czerwony wynik i musi go naprawić, zanim zmiana zostanie przyjęta.
W praktyce wystarczą trzy rzeczy. Każdy moduł ma publiczne wejście i część wewnętrzną, do której z zewnątrz nikt nie sięga. Kontrola importów jest krokiem w CI, więc agent dostaje czerwony wynik zamiast uwagi w komentarzu. Ostatnia rzecz to cykle zależności, które Shopify wskazuje jako jeden z głównych problemów: centralna klasa sklepu była zależnością niemal wszystkiego. Zespół z Shopify zaznacza też, że najtrudniejsza okazała się zmiana zachowań programistów, a nie samo narzędzie. W 2020 roku Packwerk obejmował około jednej trzeciej komponentów, a większość nie miała jeszcze mocnych granic. Rozsądniej więc zaczynać od jednego modułu niż od całości.
Kontrakt to opis wejścia i wyjścia modułu albo API, który da się sprawdzić automatycznie: schemat, typy i test, który zawodzi, gdy ktoś go złamie. W dokumentacji Claude Code jest przykład reguły ograniczonej do katalogu z API: każdy nowy endpoint wymaga wpisu w pliku openapi.yaml, a CI zawodzi bez niego. Raport DORA dodaje zasady dla zmian po stronie interfejsu: testy kontraktowe, wsteczna zgodność, wersjonowanie, najwyżej dwie równoległe wersje API, okres przejściowy do sześciu miesięcy i odpowiedź 410 Gone po wycofaniu endpointu. W monolicie część tych zasad jest lżejsza, bo moduły wdrażasz razem. Zachowaj je jednak dla granicy z aplikacją mobilną, integracjami i klientami zewnętrznymi. Moim zdaniem kontrakt modułu w monolicie sprawdza kompilator lub test w jednym uruchomieniu, a kontrakt usług wymaga uruchomienia i uzgodnienia obu stron, więc ta sama dyscyplina kosztuje tam więcej. Zacznij od jednego pliku z opisem API.
Typy działają jak darmowe sprawdzenie. GitHub w raporcie Octoverse 2025 podaje, że w sierpniu 2025 TypeScript wyprzedził Python i JavaScript pod względem miesięcznych współtwórców (2 636 006), a rosnący udział języków typowanych wiąże z tym, że „systemy typów zmniejszają niejednoznaczność i wyłapują błędy modeli przed produkcją”. To obserwacja GitHuba o trendzie, nie dowód przyczynowy, i nie rekomendacja konkretnego języka. W kontekście granic oznacza ona tyle, że publiczne wejście modułu warto opisać typami, które kompilator albo walidator sprawdza za agenta.
Migrację strukturalną trzeba rozbić na kilka kroków wdrażanych osobno, zamiast jednej zmiany, która naraz zmienia schemat i kod. Stripe opisał w 2017 roku czteroetapowy wzorzec: zapisywanie jednocześnie do starej i nowej tabeli, przełączenie wszystkich odczytów na nową tabelę, przełączenie wszystkich zapisów tylko na nową, usunięcie starych danych. Każdy etap można wdrożyć, sprawdzić i w razie potrzeby cofnąć. Pierwszy krok, podwójne zapisywanie do starej i nowej tabeli, utrzymuje je w zgodzie, a stare dane usuwa dopiero czwarty, ostatni krok. To pasuje do pracy z agentem, bo każdy krok da się zamknąć w osobnym, małym diffie, który człowiek faktycznie przeczyta. Rekomenduję zlecać agentowi jeden krok na raz i wymagać, żeby migracja trafiała do przeglądu przed wdrożeniem. Dokumentacja Claude Code wymienia „co wymaga przeglądu migracji” wśród decyzji, których agent nie odczyta z kodu i które należy zapisać w pliku instrukcji.
Układ modułowy pomaga w prosty sposób: jeśli każdy moduł jest właścicielem swoich tabel, a inne moduły sięgają do nich przez publiczne wejście, to zakres migracji jest jednym katalogiem. To moja rekomendacja, nie wynik badania. W mikroserwisach każda osobna baza to osobna ścieżka migracji do pilnowania, a kroki ze Stripe trzeba skoordynować między wdrożeniami kilku usług.
Dla małego zespołu rekomenduję jedno repozytorium z modułami jako katalogami, bo agent widzi całość, a zmiana na styku modułów trafia do jednego pull requestu. Segment po powrocie do jednego serwisu scalił kod do jednego repozytorium i ujednolicił wersje wszystkich 120 unikalnych zależności. Instrukcje dla agenta dobrze się w takim układzie rozkładają. Standard AGENTS.md zaleca w dużych repozytoriach dodatkowe pliki w podprojektach, a agent czyta najbliższy plik, przy czym „najbliższy AGENTS.md wygrywa”. Strona standardu podaje, że używa go ponad 60 tysięcy projektów open source. Claude Code ładuje plik z podkatalogu dopiero wtedy, gdy agent otworzy w nim jakiś plik, i zaleca trzymać każdy plik poniżej 200 linii. Pełniej piszę o tym w artykule o AGENTS.md i CLAUDE.md. Moim zdaniem jest tu jeszcze jedna zaleta: pull request z pełną zmianą, razem z testem i migracją, da się przejrzeć w jednym miejscu.
Poniższy układ pokazuje, jak to wygląda w praktyce: wspólny plik w korzeniu, osobny w module, opis API w jednym miejscu i katalog z kontrolami w CI.
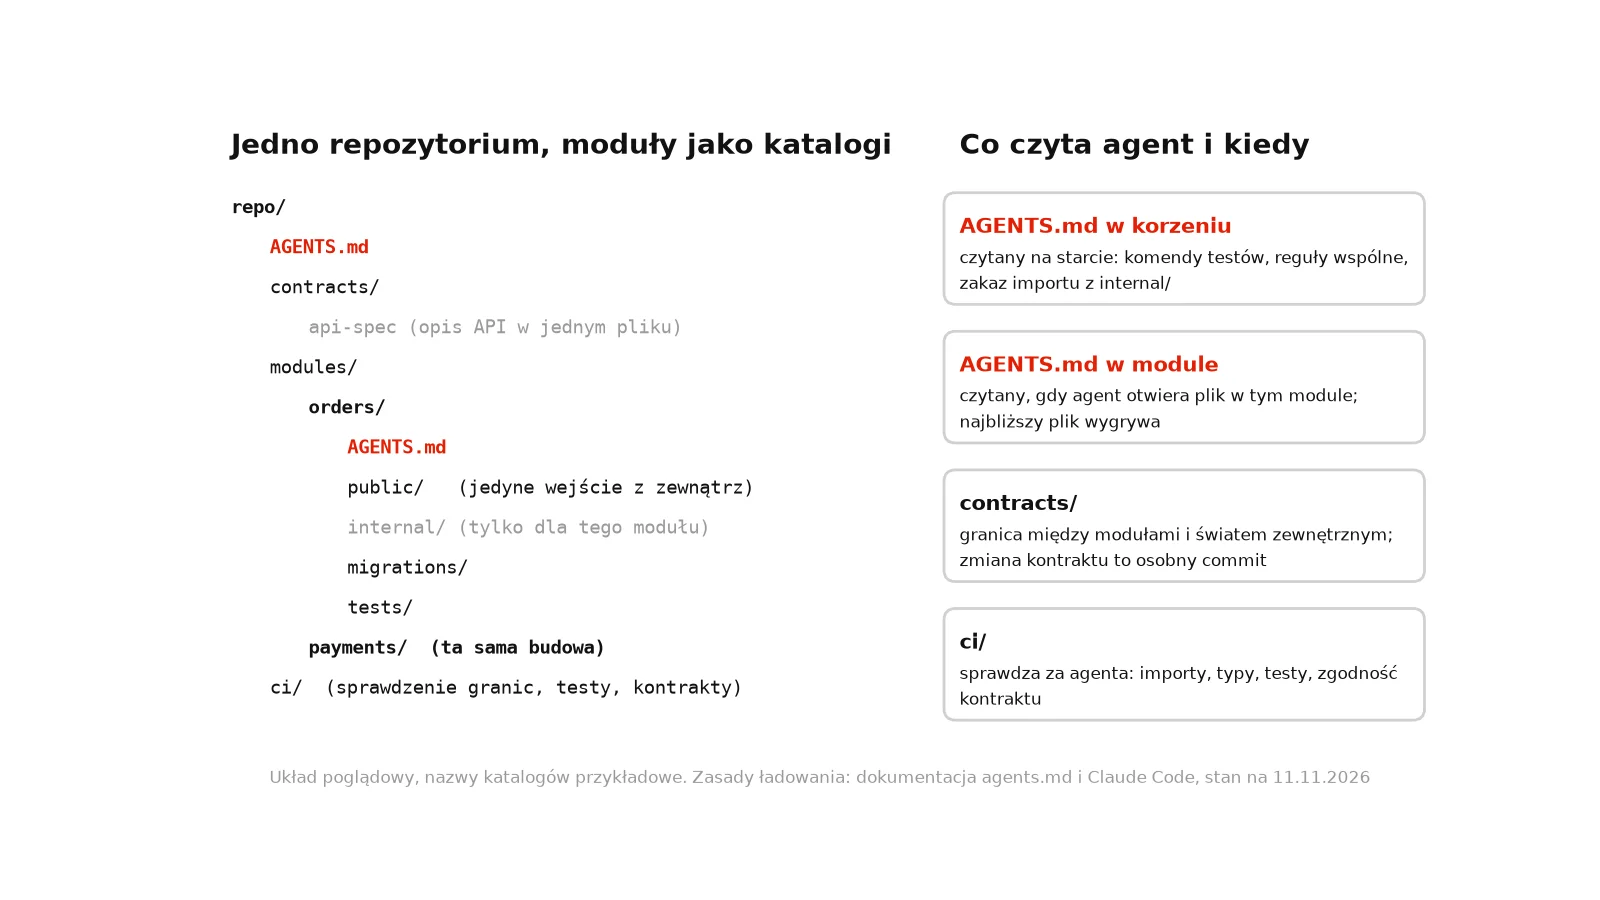
W każdym pliku z instrukcjami zapisuj tylko to, czego agent nie wyczyta z kodu: komendy testów i typów, miejsca, w których kod wprowadza w błąd, decyzje spoza repozytorium. Tak radzi dokumentacja Claude Code. Wiele repozytoriów ma sens, gdy zespoły są niezależne. Wtedy kontrakty i wersje trzeba prowadzić jak publiczne API.
Mikroserwis ma sens wtedy, gdy jeden fragment systemu ma wymagania, których reszta nie ma, albo gdy niezależne zespoły muszą wydawać zmiany w swoim rytmie. Shopify, mimo modularnego monolitu, wydziela usługi z konkretnych powodów, a jako przykłady podaje renderowanie sklepów i przechowywanie danych kart płatniczych. Raport DORA opisuje drugi powód: zespół, który może zmieniać i wdrażać swoją część bez zgody i pomocy innych, a poszczególne części architektury ewoluują stopniowo, na przykład wzorcem strangler fig, zamiast przepisywania od zera. Prime Video pokazuje drugą stronę: gdy rozproszenie nie przynosiło korzyści, zespół scalił komponenty w jeden proces. Wspólna cecha obu przykładów: usługa powstaje z wykrytej potrzeby, a nie z założenia na starcie. To zgodne z Fowlerem, który wskazuje, że granice trudno trafić na starcie. Brak korzyści z podziału jest moim zdaniem wystarczającym powodem, żeby go nie robić, a powód za podziałem powinien dać się wskazać jednym zdaniem.
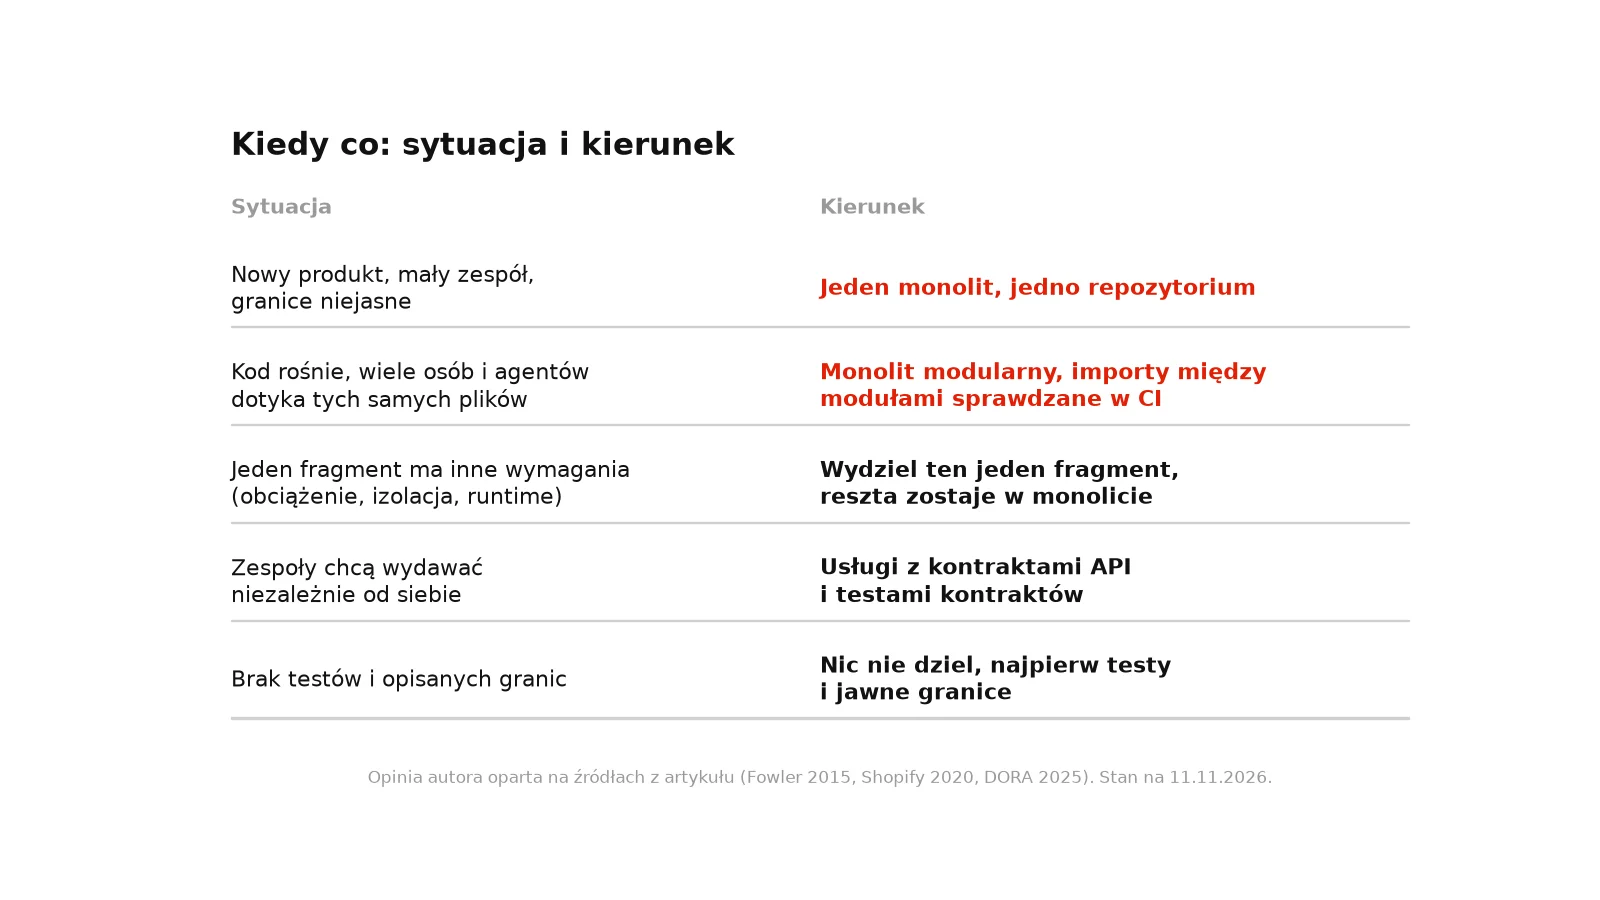
Poniższa tabela porządkuje sygnały. To moja ocena oparta na źródłach z artykułu, nie reguła z jednego badania.
| Sytuacja | Kierunek | Na czym się opieram |
|---|---|---|
| Nowy produkt, mały zespół, niejasne granice | Jeden monolit, jedno repozytorium | Fowler, MonolithFirst |
| Kod rośnie, wiele osób i agentów dotyka tych samych plików | Monolit modularny z kontrolą importów w CI | Shopify, Packwerk |
| Jeden fragment ma inne wymagania | Wydziel ten fragment, resztę zostaw | Shopify: renderowanie sklepów, przechowywanie kart |
| Zespoły chcą wydawać niezależnie | Usługi z kontraktami i testami kontraktów | DORA, zespoły luźno powiązane |
| Brak testów i opisanych granic | Nic nie dziel, najpierw testy i jawne granice | Dokumentacja Claude Code: sprawdzenie dla agenta |
Monolit modularny nie naprawi braku testów, nie pilnuje się sam i nie daje izolacji awarii, którą dają osobne procesy. Moim zdaniem granice bez sprawdzania w CI zanikają, bo każda zmiana jest szybsza przez skrót niż przez publiczne wejście. Shopify opisuje, że do utrzymania porządku potrzebowało nie tylko narzędzia, lecz też społeczności: gildii architektury z około 400 członkami i 54 udokumentowanymi spotkaniami. Segment wymienia po stronie jednego serwisu konkretne koszty: awaria jednego celu może położyć wszystkie, a aktualizacja jednej zależności może zepsuć kilka celów naraz. Shopify podaje, że w 2020 roku Packwerk działał na około jednej trzeciej komponentów, więc nawet tam granice utwardzano stopniowo. Moim zdaniem największe ryzyko to złudzenie porządku: katalogi wyglądają jak moduły, ale importy przechodzą wszędzie. Dlatego sprawdzaj nie tylko, że moduły istnieją, lecz że zmiana łamiąca granicę faktycznie zawodzi w CI.
Ten układ jest złym pomysłem, gdy dwa fragmenty systemu mają radykalnie różne wymagania co do obciążenia albo izolacji i przeszkadzają sobie w jednym procesie. Nie jest też lekarstwem, gdy zespół nie umie opisać, co dany moduł robi. Wtedy najpierw trzeba spisać granice, a dopiero potem je utwardzać. Ten artykuł nie rozstrzyga też wyboru języka, bazy ani hostingu i nie zastępuje przeglądu bezpieczeństwa. O bezpieczeństwie piszę w artykule o kodzie z AI, o wdrażaniu w tekście o hostingu, a o testach i przeglądzie zmian agenta w artykule o testach, review i CI.
Portal klienta to jedna aplikacja Next.js z jedną bazą, a nie kilka usług. Granice trzymamy w plikach. Reguła, co klient może zrobić ze statusem zgłoszenia, siedzi w jednym pliku clientStatusRules.ts i nie ma dostępu do bazy, bo plik importowany przez komponent kliencki nie może wciągać sterownika Postgresa do paczki przeglądarki. Przyczyną tej reguły było pytanie klienta w październiku: portal pozwalał przeciągnąć kartę do każdej kolumny, a trasa PATCH przyjmowała dowolny status, choć umowa mówiła co innego.
Decyzje zapisujemy jako krótkie dokumenty. Portal ma katalog docs/decyzje/, a couchterm 29 rekordów w docs/adr/ oraz słownik pojęć w CONTEXT.md, żeby agent nazywał rzeczy tymi samymi słowami co my. Sherpa pokazuje drugą stronę: backend to jeden plik Pythona, server.py, ponad 260 kB, a w naszym inwentarzu aplikacji jest to wpisane jako dług techniczny. Mimo to jej nie dzielimy na usługi, tylko przepisujemy front. Opinia: dopóki zespół jest mały, granice w kodzie i zapisane decyzje dają agentowi więcej niż osobne wdrożenia.
Nie. To narzędzie z wysokim kosztem stałym, które opłaca się przy konkretnych problemach. Fowler nazywa ten koszt premią i radzi nie sięgać po nią, dopóki system nie jest zbyt złożony na monolit.
To moja robocza nazwa na usługi, które formalnie są osobne, ale trzeba je wdrażać razem, więc płaci się koszty obu światów. Raport DORA zauważa, że wiele architektur usługowych nie daje niezależności, dla której je wybrano.
W źródłach nie znalazłem progu. Fowler widział zespół sześćdziesięciu osób z 20 usługami i zespół czterech osób z 200 usługami, więc sama liczba osób nie rozstrzyga. Moja ocena: przy zespole od jednej do kilku osób zacznij od monolitu.
Potrafi, ale z zastrzeżeniami. W pracy arXiv 2603.09004 oceniono 144 wygenerowane usługi. Autorzy ocenili, że w pełni autonomiczne generowanie mikroserwisów nie jest jeszcze osiągalne i nadal potrzebny jest nadzór człowieka.
Dla małego zespołu rekomenduję jedno repozytorium z modułami jako katalogami, bo agent i test widzą całość. Segment po scaleniu kodu ujednolicił wersje 120 zależności. Wiele repozytoriów ma sens przy niezależnych zespołach.
Tak. Fowler obserwuje, że udane historie mikroserwisów zaczynały się od monolitu, który urósł i został rozbity. DORA wskazuje wzorzec strangler fig, czyli stopniowe wydzielanie zamiast przepisywania od zera. Moduły z jawnymi granicami ten krok ułatwiają.
Nie. Według dokumentacji Claude Code plik z instrukcjami to kontekst, a nie wymuszona konfiguracja. Reguły bez wyjątków przenieś do hooków albo CI.
Stan na 11 listopada 2026. Wpisy Prime Video, Segment i Shopify to relacje zespołów o własnych systemach, a nie kontrolowane badania, więc traktuj je jako przykłady, nie jako dowód ogólny.
Zostań w pętli
Nowe artykuły, narzędzia i case study prosto na maila. Bez spamu, bez sprzedaży.